Entrega de software
Como diagnosticar onde a entrega de software realmente trava
A maioria das equipes de engenharia lentas tem um problema de fluxo, e a produtividade das pessoas pouco tem a ver com isso. E quase todo mundo reage a ele de um jeito que deixa o sistema ainda mais lento.
Um padrão que vi muitas vezes ao longo dos anos: uma equipe de seis pessoas com 60–80 tarefas ativas no quadro, releases que passaram de dias para semanas e depois para "a gente vê isso mês que vem", e a conclusão muito razoável de que mais gente vai resolver. Quase nunca o gargalo real está aí.
O diagnóstico decompõe a linha do tempo de uma única tarefa, da ideia até o usuário, até que você consiga apontar a etapa exata em que o sistema para de funcionar. Quando você consegue apontá-la, a solução costuma ser óbvia, e na maioria das vezes não envolve contratar ninguém. A ordem abaixo segue um trabalho real: sintomas → decomposição → encontrar o gargalo → discutir a alavanca.
1. Sintomas de entregas lentas, e o primeiro reflexo errado
A primeira conversa quase sempre começa do mesmo jeito. O T2M se mede em meses. O throughput está perto de zero. Há mais bugs no quadro do que tarefas abertas. O NPS da equipe, interno ou externo, está em algum ponto entre ruim e péssimo.
Os engenheiros estão trabalhando, o EM está se esforçando, o PM está ralando para dar conta do backlog. E mesmo assim o primeiro reflexo, toda santa vez, é "precisamos de mais engenheiros", e esse é o reflexo errado.
O motivo é este. Quando um programa não funciona, a gente não conserta colocando mais desenvolvedores no código. A gente abre um depurador. Olha em que estado o programa está, onde ele está travando, o que ele está fazendo de fato em comparação com o que esperávamos. Com um sistema de engenharia é igual. As métricas acima dizem que o resultado é ruim. Elas não dizem onde o sistema está quebrando. Aumentar a equipe sem essa informação só deixa o sistema mais complexo (mais passagens de bastão, mais trabalho em andamento, filas maiores) e quase sempre mais lento.
Então, antes de qualquer conversa sobre contratação, o trabalho é decompor o processo em partes e encontrar onde ele começa a degradar. É nesse momento que as métricas deixam de ser um boletim e passam a ser uma ferramenta de diagnóstico.
2. Decomponha o T2M: Discovery e Lead Time são problemas diferentes
Quando uma tarefa aparece, ela ainda é só uma ideia crua: um pedido de cliente, um relato de bug, uma hipótese do fundador, algo que alguém notou numa reunião. Antes que a equipe possa construí-la, alguém precisa dar forma a ela: esclarecer o que ela quer dizer, esboçar a solução, decidir se vale a pena, conseguir as aprovações certas. Nem toda ideia passa por essa etapa, e as que passam nem sempre passam rápido.
Esse intervalo importa, porque é nele que muitas equipes queimam semanas sem perceber. T2M, o Time to Market, é o tempo total da ideia até a produção. O primeiro corte útil nele é a fronteira entre Discovery e Delivery.
Discovery é tudo o que acontece antes de um ticket estar realmente pronto para um desenvolvedor pegar. Esclarecimento de requisitos, design, definição de escopo, alinhamento com stakeholders, priorização. O resultado: um ticket que alguém de fato consegue começar a construir.
Delivery é tudo o que vem depois desse ponto, de "pronto para desenvolvimento" a "em produção". É o que a maioria das métricas de engenharia mede implicitamente, e é a fatia que a equipe controla diretamente.
A métrica que uso para a segunda metade é o Lead Time: o tempo que um ticket passa especificamente sob a responsabilidade da equipe de desenvolvimento. Portanto:
T2M = Discovery + Lead Time (Delivery)
Dois números, dois problemas bem diferentes escondidos atrás de um único T2M ruim.
Se o T2M é alto, mas o Lead Time é baixo, o gargalo está antes da engenharia. A equipe consegue executar, mas o trabalho está parado na análise, esperando um stakeholder, na fila de uma decisão de prioridade que ninguém tomou. Contratar mais engenheiros não vai ajudar: eles só vão ficar ociosos de outro jeito. O trabalho é consertar o pipeline de Discovery: quem decide o que está pronto, com que cadência, com que informações.
Se o Lead Time é alto, o problema está dentro do próprio Delivery. As tarefas travam depois que a equipe as pega: no código, na revisão, no QA, no deploy. Precisamos olhar dentro do Lead Time e descobrir onde, exatamente, o tempo está sendo gasto.
Na prática, a maioria das equipes com que trabalho tem problemas dos dois lados, mas raramente na mesma proporção. A primeira coisa que a separação entre T2M e Lead Time faz é dizer qual conversa ter primeiro. O lado do Discovery costuma ser uma conversa com o fundador, o PM e quem for dono da priorização. O lado do Delivery é uma conversa com o EM e a equipe. Misturar os dois é um dos jeitos mais garantidos de aplicar a correção errada.
Dentro do Lead Time, "estar trabalhando numa tarefa" e "a tarefa estar sendo trabalhada" acabam sendo coisas diferentes, e é aí que a coisa fica interessante.
3. Lead Time = Espera + Cycle Time
A maioria das equipes acha que, quando uma tarefa está "pronta para desenvolvimento", o trabalho de verdade começou. Não começou. A tarefa vai para o quadro. Um desenvolvedor está ocupado com a anterior. Alguém está de férias. Um bug mais prioritário fura a fila. O ticket fica lá parado. Do ponto de vista do quadro, a tarefa está "em andamento". Do ponto de vista do sistema, ela só está esperando.
Por isso o Lead Time sozinho não é preciso o bastante. Precisamos separar o tempo em que uma tarefa está de fato sendo trabalhada do tempo em que ela só está parada numa fila. A métrica que uso para isso é o Cycle Time: o tempo desde o momento em que a tarefa é realmente pega até ela ficar pronta. Só trabalho de verdade.
Empilhando tudo:
Lead Time = Espera + Cycle Time
Cycle Time = só trabalho
Daí saem mais duas perguntas de diagnóstico.
Se o Cycle Time é alto, o problema está dentro do próprio desenvolvimento. Quando as pessoas começam a trabalhar numa tarefa, ela demora a terminar. O gargalo está na execução: complexidade do código, demora na revisão, testes instáveis, ciclos de QA manual, deploys sofridos. É por aí que você começa a olhar junto com a equipe.
Se o Cycle Time é baixo, mas o Lead Time é alto, a equipe vai bem. A execução vai bem. O sistema recebe mais trabalho do que dá conta. As tarefas se acumulam na fila, esperando a equipe terminar o lote anterior antes de poderem sequer começar.
É esse segundo caso que pega os fundadores de surpresa. A equipe anda rápido em cada tarefa individual. O quadro continua parecendo congelado. O instinto é pressionar o throughput individual, quando o problema real é a demanda que chega em comparação com a capacidade da equipe. A conversa certa aqui é sobre adicionar capacidade de forma pontual ou limitar quanto trabalho a equipe aceita de uma vez. Chegaremos lá.
Tabela rápida de diagnóstico para a primeira conversa com a liderança:
| O que a métrica mostra | O que significa |
|---|---|
| Cycle Time alto | Problema de execução: olhe dentro do desenvolvimento. |
| Lead Time alto, Cycle Time normal | A demanda é maior que a capacidade. |
| Cycle Time baixo, Lead Time baixo, T2M alto | O gargalo está no Discovery; o Delivery vai bem. |
São três números. Dá para tirar todos do Jira ou do Linear numa tarde, e eles já vão contar uma história diferente de "precisamos contratar".
4. Onde o trabalho realmente trava: por que o tempo por status pode enganar
Então o Cycle Time está alto. O próximo passo natural é olhar dentro dele: medir o tempo em cada status. Em andamento, Code Review, QA, Deploy. Somar para onde vão as horas. Achar a coluna mais lenta. Consertá-la.
É o que a maioria das equipes faz, e funciona até certo ponto. Se as suas tarefas estão travando na revisão de código, dá para ler o tempo da coluna e começar uma conversa real sobre a carga dos revisores, o tamanho dos PRs, o SLA de revisão. O mesmo vale para gargalos de QA e filas de deploy. Os dados são reais e a intervenção é direcionada.
Mas há uma armadilha, e quero ser específico sobre ela.
As tarefas vão e voltam entre as etapas: do QA para o desenvolvimento quando aparece um bug, da revisão de volta para o trabalho quando chega um comentário, do deploy de volta para o dev quando algo falha em staging. A mesma tarefa passa pela mesma etapa duas, três, às vezes cinco vezes. No momento em que você começa a medir o "tempo médio em QA", essa média mistura em silêncio tickets na primeira passagem com tickets na terceira volta ao QA.
O que a maioria das equipes faz nesse ponto é dobrar a aposta na medição. Dashboards mais detalhados. Rastrear cada transição. Adicionar métricas como "taxa de reprovação no QA na primeira passagem" e "retornos da revisão por ticket". Montar relatórios personalizados no Jira. No fim, você tem um instrumento lindo com o qual ninguém consegue agir, porque os dados ficaram complicados mais rápido do que o sistema por baixo ficou claro.
O erro é tentar medir o sistema no nível errado. A otimização local, deixar cada coluna mais rápida, pressupõe que o trabalho flui em linha reta. Na realidade, o sistema é um fluxo cheio de redemoinhos, voltas e filas, bem diferente de uma esteira.
A virada que realmente ajuda é parar de tentar medir cada etapa com mais precisão e começar a perguntar como o trabalho se move pelo sistema como um todo. A pergunta passa a ser "quantos tickets estão no sistema ao mesmo tempo, e que proporção deles está de fato avançando, em vez de só ficar parada ali". Quando você faz essa pergunta, o resto do diagnóstico fica bem mais simples.
5. Como achar gargalos sem medir tempo
Esta é a jogada de diagnóstico mais subestimada que eu conheço.
Você não precisa medir o tempo em cada status para achar o gargalo. Basta contar as tarefas em cada status.
Tire os números do Jira em cinco minutos. O formato quase sempre fica parecido com isto:
Depois, procure os desequilíbrios.
Se você tem cinco tarefas em desenvolvimento, três em revisão e vinte e cinco em QA, não precisa de cronômetro. Não precisa de um dashboard no Looker. O gargalo é o QA. As tarefas se acumulam ali, mesmo que cada uma, isoladamente, ande no ritmo normal. O sistema tem um ponto onde o trabalho se acumula mais rápido do que escoa.
Essa contagem simples diz quase tudo o que o tempo por status diria, com cerca de um por cento do esforço. Funciona porque as filas são o lado visível de um problema de fluxo: onde as filas se formam, é ali que a capacidade do sistema está batendo no teto.
Ela também muda o rumo da conversa. O tempo por status convida a um debate sobre "quanto tempo em QA é demais". A contagem de tarefas deixa o problema evidente: vinte e cinco coisas esperando por dois engenheiros de QA é um problema do sistema, e pedir que o QA trabalhe mais rápido passa longe dele.
É o diagnóstico mais barato e mais rápido do guia, e a maioria das equipes passa direto por ele a caminho de montar dashboards que nunca vai usar.
Mas ele levanta uma pergunta mais profunda. Por que há vinte e cinco tarefas em QA? De onde elas vieram? Por que a equipe continua aceitando trabalho novo quando já existe uma muralha de tickets inacabados no sistema?
6. Trabalho em andamento (WIP): a variável que controla a velocidade de entrega
Seis engenheiros. Oitenta tarefas em andamento. Nada fica pronto.
Não estou exagerando. Vi exatamente esse formato várias vezes. Uma equipe de três desenvolvedores, dois engenheiros de QA e um tech lead, com mais de oitenta tickets ativos no quadro. Para uma equipe de seis.
A história por trás é sempre a mesma. Um desenvolvedor termina a parte ativa de uma tarefa e a manda para revisão. Agora o ticket atual dele está bloqueado por outra pessoa. Em vez de esperar, ele pega outro do backlog. Esse também fica bloqueado, esperando o QA. Ele pega mais um. O quadro se enche de tarefas que tecnicamente estão "em andamento", mas na verdade estão esperando alguém, em outro lugar, por algum outro motivo.
Isso é o Work in Progress (WIP), o trabalho em andamento: o número de tarefas que o sistema segura ao mesmo tempo.
A equipe não consegue fisicamente trabalhar em oitenta coisas ao mesmo tempo. Seis pessoas, oitenta tarefas. A maior parte do trabalho está só parada. Esperando revisão, bloqueada no QA, estacionada porque um stakeholder não respondeu, parcialmente pronta e mergeada, mas ainda sem deploy. Cada um desses tickets ocupa um espaço no sistema: um espaço no contexto mental de alguém, um lugar no quadro, um pedaço de estado que alguém precisa manter aquecido.
O custo se acumula:
- As tarefas perdem relevância para o negócio enquanto esperam. Quando a equipe volta a elas, os requisitos mudaram ou a urgência evaporou.
- Os conflitos de merge se acumulam. Uma branch de funcionalidade que fica parada três semanas enquanto a branch principal segue em frente vira um pequeno projeto de arqueologia para integrar.
- A troca de contexto fica cara. Cada desenvolvedor carrega na cabeça três ou quatro tarefas "em andamento" ao mesmo tempo. Nenhuma delas está avançando de fato.
- Fica mais fácil colocar bugs em produção. Com mais trabalho em andamento, menos olhos ficam em cada peça. A qualidade cai.
E as métricas confirmam. WIP alto anda junto com T2M alto (as tarefas demoram mais para sair), throughput baixo (menos tarefas terminam por semana), mais bugs (menos atenção por tarefa) e NPS mais baixo, tanto dos clientes quanto da equipe.
A variável que controla o sistema é quanto a equipe tenta manter em andamento ao mesmo tempo. Ela pesa mais do que a velocidade da equipe e mais do que a senioridade dos engenheiros.
7. Lei de Little: Lead Time = WIP / Throughput
Se as seções anteriores parecem chegar sempre à mesma conclusão, você tem razão. E há um motivo.
A pesquisa operacional descobriu isso há décadas. A relação entre a quantidade de trabalho num sistema e o tempo que esse trabalho leva é descrita pela Lei de Little:
Lead Time = WIP / Throughput
Na linguagem da entrega de software:
- WIP: quantas tarefas estão no sistema ao mesmo tempo
- Throughput: quantas tarefas a equipe conclui por período
- Lead Time: quanto tempo uma tarefa vive no sistema, em média
A fórmula é quase constrangedora de tão simples, e a consequência é brutal.
Mantenha o throughput constante e aumente o WIP, e o lead time cresce na mesma proporção. Exemplo prático: uma equipe que conclui dez tarefas por semana.
10 tarefas no sistema → lead time médio ≈ 1 semana
30 tarefas → ≈ 3 semanas
80 tarefas → ≈ 8 semanas
A equipe trabalha na mesma velocidade nos três cenários. Os engenheiros não ficaram mais lentos. Os tickets não ficaram mais complexos. A única coisa que mudou foi quantas tarefas o sistema tenta segurar ao mesmo tempo. E o lead time médio ficou 8 vezes maior.
É por isso que equipes que trabalham mais não necessariamente entregam mais rápido. Com esforço, dá para subir o throughput em 10–20%. Com disciplina, dá para baixar o WIP em 50% ou mais. A matemática diz que a segunda alavanca mexe mais nos resultados.
É também por isso que "precisamos de mais engenheiros" tantas vezes piora as coisas. Engenheiros novos trazem o próprio trabalho em andamento. O WIP sobe mais rápido que o throughput, e o lead time piora antes de melhorar. O onboarding torna isso quase garantido: os recém-contratados levam de seis a oito semanas para começar a contribuir de forma significativa, e nesse período o WIP da equipe atual aumenta (mentoria, passagem de contexto, revisão dos PRs dos novatos).
Se for guardar um único número, guarde este. Lead Time = WIP / Throughput.
É a matemática do sistema por trás de quase toda conversa do tipo "estamos andando devagar" que já tive em engenharia.
8. Limites de WIP: a alavanca que conserta a maioria das equipes lentas
Então, se o WIP é a variável que controla a velocidade do sistema, e normalmente não dá para mudar o throughput de forma drástica no curto prazo, a alavanca é óbvia: limitar o WIP.
A maioria das equipes de engenharia tem um problema de produtividade porque tem um problema de WIP. Conserte o WIP, e a maior parte dos outros sintomas (lead times longos, bugs frequentes, pouca previsibilidade, troca de contexto sem fim) melhora junto.
Limites de WIP são a disciplina de dizer: este sistema não vai segurar mais do que N tarefas ao mesmo tempo. Se o WIP está no limite, nenhum trabalho novo começa até que algo em andamento termine. Ponto.
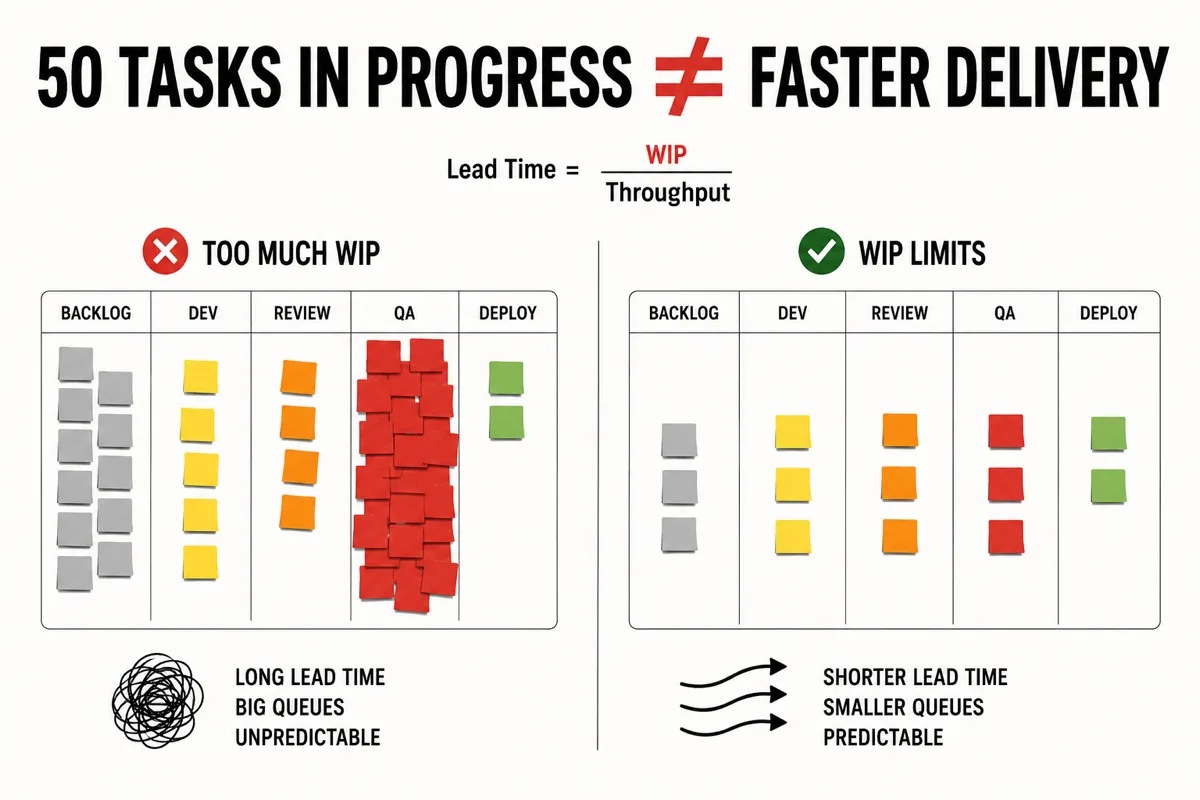
O que os limites de WIP de fato melhoram:
- Menos troca de contexto, porque cada pessoa carrega menos coisas em andamento
- Filas mais curtas em cada etapa, porque há menos coisa no sistema como um todo
- Lead Time mais curto, pela Lei de Little, mecanicamente
- Menos bugs, porque a atenção se concentra em terminar em vez de começar
- Mais previsibilidade, porque o sistema para de oscilar entre ocioso e engarrafado
Os limites de WIP fazem o sistema andar mais rápido, e cada desenvolvedor continua no mesmo ritmo. É essa parte que confunde a liderança. A equipe produz a mesma quantidade de código por hora de trabalho, só que com menos peças pela metade em paralelo, e assim mais do que ela produz chega de fato à produção.
É também uma das pouquíssimas alavancas que melhoram as entregas sem contratar, sem ferramentas novas e sem redesenhar processos. Não custa nada. Dá para aplicar nesta semana. E quase ninguém aplica, porque exige dizer "não" a começar trabalho novo, e dizer "não" a um stakeholder que pede mais uma coisa em andamento é mais difícil do que dizer "sim".
Limites de WIP dependem bem menos das configurações do Jira do que da disciplina da equipe e dos stakeholders de terminar antes de começar.
9. Como introduzir limites de WIP sem revolta na equipe
A matemática é uma coisa. Convencer o sistema a adotá-la é outra. É grande o número de equipes que leram sobre limites de WIP, tentaram implementá-los e abandonaram a tentativa sem alarde. Eu diria que é a maioria.
O modo de falha é este. Alguém, normalmente o EM ou um engenheiro sênior que leu o livro de Kanban, declara: "a partir de segunda, o limite de WIP é 5 por desenvolvedor, sem exceções". Duas semanas depois, acabou. Os motivos da morte são previsíveis:
- Os desenvolvedores veem colegas bloqueados na revisão ou no QA, se recusam a "ficar parados" enquanto há trabalho no backlog e, discretamente, começam tickets novos mesmo assim
- Um stakeholder precisa de algo urgente, o EM recebe pressão de cima, e o limite é suspenso "só desta vez"
- A liderança passa pela área de engenharia, vê pessoas que não estão digitando e pergunta por que a equipe não está sendo totalmente aproveitada
Os limites de WIP pegam quando entram como uma mudança de foco. Quase ninguém, nem os desenvolvedores nem a liderança, acha a regra em si intuitiva. Visto de fora, dizer a um desenvolvedor que não pegue trabalho novo parece irracional. É uma postura contra a escassez, numa cultura que recompensa começar coisas.
Por isso eu raramente começo pelo limite em si. Começo deslocando o foco da equipe de começar trabalho para terminar trabalho. O limite é absorvido depois dessa mudança de foco.
A sequência que uso, mais ou menos:
- Deixe o objetivo explícito. O objetivo é terminar o trabalho que já começou. Repita isso com frequência. Imprima num adesivo. O que for preciso para essa ideia pegar.
- Explique o porquê. Mostre à equipe a Lei de Little. Mostre o diagnóstico de contar tarefas por status. Argumente com a matemática do sistema, sem apelar para a autoridade. As pessoas seguem muito melhor as práticas que entendem do que regras que não entendem.
- Mostre exemplos reais. Cite casos em que a introdução de limites de WIP mudou o sistema de forma visível: suas equipes anteriores, textos como este, histórias de outras pessoas. Reconhecer o padrão faz a maior parte do trabalho que a exortação não consegue fazer.
- Traga o foco de volta, sempre. Sempre que alguém estiver prestes a puxar uma tarefa nova, pergunte: "o que você pode fazer agora para levar o trabalho que já existe até o fim?" Ajudar a desbloquear um colega. Fazer uma revisão. Responder a uma dúvida do QA. Parear para resolver um conflito de merge antigo. O instinto da equipe é pegar trabalho novo; a disciplina é redirecionar esse instinto.
Há uma história, num comentário em um dos meus próprios posts, que captou isso bem. Uma equipe definiu WIP = 5. No começo, os stakeholders viram isso como um fracasso: poucas coisas acontecendo ao mesmo tempo de forma visível. Em um trimestre, a velocidade de entrega melhorou, a qualidade melhorou, a colaboração melhorou, a previsibilidade melhorou. A visão dos stakeholders virou. Eles pararam de perguntar "por que há tão poucas coisas ativas" e começaram a perguntar "por que não usamos limites de WIP em outras partes da empresa".
A parte mais difícil costuma ser a camada de gestão que confunde ocupação com produtividade. Se todo mundo na equipe está "100% ocupado", a gestão fica tranquila; se alguém está visivelmente entre um ticket e outro, o alarme dispara. A verdade, desconfortável, é que uma equipe operando com 100% de ocupação quase sempre entrega menos do que uma equipe operando com 80%. É a folga no sistema que deixa o trabalho fluir por ele.
Limites de WIP não precisam ser um Kanban formal. Você não precisa imprimir números no quadro. Basta que a equipe e os stakeholders combinem, na prática: terminamos antes de começar.
10. A visão completa do sistema: velocidade, valor e sustentabilidade nas entregas
A velocidade sozinha é um retrato incompleto. Qualquer conjunto de métricas de engenharia que otimize só a velocidade vai acabar quebrando algo mais importante.
O modelo completo de diagnóstico tem três dimensões:
Velocidade do sistema: com que rapidez entregamos mudanças.
- T2M (Time to Market): o tempo total da ideia até a produção
- Throughput: tarefas concluídas por período
- Lead Time, Cycle Time, WIP: a decomposição que já percorremos
Valor do produto: se o que entregamos é de fato útil.
- Qualidade: bugs abertos, taxa de regressão, taxa de incidentes
- NPS / satisfação do cliente: se o usuário sente que o produto está melhorando
Sustentabilidade da equipe: se a equipe consegue continuar trabalhando assim.
- eNPS (Employee NPS): se a equipe recomendaria trabalhar aqui
- Sinais de burnout, taxa de rotatividade, carga de plantão
As três importam juntas porque quaisquer duas podem ser maquiadas por um tempo às custas da terceira. Dá para entregar mais rápido pulando o QA e esgotando a equipe: a velocidade sobe, o valor e a sustentabilidade desabam. Dá para polir a qualidade até a perfeição e não entregar nada: o valor por funcionalidade sobe, mas a equipe e a empresa estagnam. Dá para manter a equipe feliz e ociosa: a sustentabilidade vai ótima, a velocidade é zero.
Um sistema de entrega que funciona mantém as três dimensões em equilíbrio. É rápido o bastante para o negócio competir, valioso o bastante para os clientes ficarem e sustentável o bastante para a equipe ainda estar aqui no ano que vem. Quando fundadores me perguntam como é um sistema "bom", a resposta é esta: três números andando mais ou menos juntos.
O eNPS em particular costuma ser ignorado, porque parece mais subjetivo que os demais. Na verdade, ele é o sistema de alerta precoce para todo o resto. Uma equipe cujo eNPS está caindo vai, em três a seis meses, começar a perder as pessoas mais experientes. Quem entra no lugar são juniores que precisam de tempo para engrenar. O WIP sobe, o conhecimento fica raso, a qualidade cai, os bugs se multiplicam. A métrica que você viu se mexer primeiro foi a que você ignorou.
Dá para calcular quase todas essas métricas com o Jira e uma pesquisa de clima do RH. Nenhuma exige uma ferramenta especial. O que elas exigem é disposição para olhar o sistema com honestidade, nas três dimensões ao mesmo tempo.
Quando as métricas viram ferramenta de diagnóstico
As métricas não são novas. As ideias também não: Teoria das Restrições (anos 1980), Sistema Toyota de Produção (anos 1950), o Método Kanban para software (David Anderson, anos 2000) e a Lei de Little (1961) descrevem aspectos diferentes do mesmo problema de fundo: o trabalho se move por sistemas, e os sistemas ficam lentos quando o fluxo quebra. A novidade está em como a sua equipe as usa: como relatório ou como diagnóstico. Um relatório diz que algo está quebrado. Um diagnóstico diz onde.
Quando as entregas estão lentas, a tentação é reagir ao relatório: contratar engenheiros, adicionar processo, instalar uma ferramenta nova. A reação parece movimento. O progresso de verdade começa quando as métricas ficam específicas o bastante para apontar a restrição real.
Se você está olhando para um quadro com 60–80 tarefas ativas e uma equipe de seis pessoas, conte as tarefas por status. Meça o Lead Time e o Cycle Time. Olhe a relação entre WIP e throughput. A matemática do sistema vai fazer a maior parte do trabalho.
Perguntas frequentes
Qual é a diferença entre Lead Time e Cycle Time?
- Lead Time
- O tempo total que uma tarefa passa dentro do desenvolvimento, de “pronta para desenvolvimento” até “em produção”. Inclui a espera.
- Cycle Time
- Só a parte de trabalho ativo, de “de fato pega” até “pronta”. Exclui a espera.
A diferença entre os dois é o tamanho da fila.
Qual é um limite de WIP razoável para uma equipe de N pessoas?
As referências do mercado variam de 1–3 tarefas por desenvolvedor; equipes de desenvolvimento de software costumam ficar na ponta mais apertada, 1–2 por dev.
Equipe de 6 → ~6–12 tarefas ativas no sistema todo, em vez de 80.
O número exato importa menos do que a disciplina de ter um limite e fazê-lo valer: a maioria das equipes acha o nível certo começando apertado e afrouxando se o trabalho travar com frequência por motivos que não têm a ver com WIP.
Qual é a diferença disso para a capacidade do sprint no Scrum?
- Capacidade do sprint
- Quanto trabalho a equipe se compromete a fazer num período de duas semanas.
- Limite de WIP
- Quanto trabalho está em andamento num dado momento, independentemente do sprint.
Uma equipe pode ter um compromisso de sprint sensato e mesmo assim tocar mais de 60 tarefas em paralelo: a capacidade do sprint não diz nada sobre se o trabalho está sendo terminado ou só começado. Os limites de WIP são independentes do planejamento do sprint e costumam resolver problemas que o planejamento sozinho não alcança.
E se o nosso throughput for mesmo baixo demais?
Às vezes o throughput é de fato a restrição. Se o WIP já está sob controle e o Lead Time continua alto, talvez a equipe não tenha capacidade suficiente para a demanda.
Antes de contratar, verifique três coisas:
- As tarefas são grandes demais?
- A execução em si é lenta?
- A equipe gasta muito tempo com trabalho que não é entrega? Suporte, incidentes, reuniões, carga operacional.
Se tudo isso estiver limpo e o throughput continuar abaixo da demanda, contratar pode ser a decisão certa. Os limites de WIP ajudam a distinguir um problema de capacidade de um problema de fluxo, e a contratação continua sendo uma opção.