Livraison logicielle
Diagnostiquer où vos livraisons bloquent vraiment
La plupart des équipes de développement lentes ont en réalité un problème de flux. Et le premier réflexe de presque tout le monde face à ce problème ralentit encore le système.
Voici un schéma que j’ai vu bien des fois au fil des années : une équipe de six personnes avec 60 à 80 tâches actives au tableau, des mises en production passées de quelques jours à quelques semaines, puis à « on verra le mois prochain », et une conclusion très raisonnable : plus de bras régleront le problème. En général, le vrai goulot d’étranglement est ailleurs.
Le diagnostic décompose la trajectoire d’une seule tâche, de l’idée jusqu’à l’utilisateur, jusqu’à pouvoir désigner l’étape précise où le système cesse de fonctionner. Une fois cette étape désignée, la solution est généralement évidente, et la plupart du temps, elle ne passe par aucun recrutement. L’ordre ci-dessous suit celui d’une vraie mission : symptômes → décomposition → trouver le goulot → parler du levier.
1. Les symptômes de livraisons lentes, et le mauvais premier réflexe
La première conversation commence presque toujours de la même façon. Le T2M se compte en mois. Le débit est proche de zéro. Il y a plus de bugs au tableau que de tâches ouvertes. Le NPS de l’équipe, interne ou externe, oscille entre mauvais et pire.
Les ingénieurs travaillent, l’engineering manager fait de son mieux, le product manager avance péniblement dans le backlog. Et pourtant, le premier réflexe, à chaque fois, est « il nous faut plus d’ingénieurs ». C’est le mauvais réflexe.
Voici pourquoi. Quand un programme ne fonctionne pas, on ne le répare pas en ajoutant des développeurs au dépôt. On ouvre un débogueur. On regarde dans quel état se trouve le programme, où il bloque, ce qu’il fait réellement par rapport à ce qu’on attendait. Il en va de même pour un système d’ingénierie. Les métriques ci-dessus vous disent que le résultat est mauvais. Elles ne vous disent pas où le système déraille. Faire grandir l’équipe sans cette information ne fait que complexifier le système (plus de passages de relais, plus de travail en cours, des files d’attente plus profondes) et le rend presque toujours plus lent.
Avant toute discussion sur le recrutement, il faut donc décomposer le processus en ses différentes parties et trouver où il commence à se dégrader. C’est à ce moment-là que les métriques cessent d’être un bulletin de notes pour devenir un outil de diagnostic.
2. Décomposer le T2M : Discovery et Lead Time sont deux problèmes distincts
Quand une tâche apparaît, ce n’est pas encore vraiment une tâche. C’est une idée brute : une demande client, un rapport de bug, une hypothèse du fondateur, quelque chose que quelqu’un a remarqué en réunion. Avant que l’équipe puisse la construire, quelqu’un doit lui donner forme : clarifier ce qu’elle signifie vraiment, esquisser la solution, décider si elle en vaut la peine, obtenir les bonnes validations. Toutes les idées ne franchissent pas cette étape, et celles qui la franchissent ne le font pas toujours vite.
Cet intervalle compte, parce que c’est là que beaucoup d’équipes brûlent des semaines sans s’en rendre compte. Le T2M, ou Time to Market, est le temps total qui sépare l’idée de la mise en production. Le premier découpage utile se fait à la frontière entre Discovery et Delivery.
La Discovery regroupe tout ce qui se passe avant qu’un ticket soit réellement prêt à être pris par un développeur. Clarification des exigences, conception, cadrage, alignement des parties prenantes, priorisation. Résultat : un ticket que quelqu’un pourrait effectivement commencer à développer.
La Delivery regroupe tout ce qui vient après, de « prêt pour le développement » à « en production ». C’est ce que mesurent implicitement la plupart des métriques d’ingénierie, et c’est la partie sur laquelle l’équipe a une prise directe.
La métrique que j’utilise pour cette seconde moitié est le Lead Time : le temps qu’un ticket passe précisément sous la responsabilité de l’équipe de développement. Donc :
T2M = Discovery + Lead Time (Delivery)
Deux chiffres, et deux problèmes très différents cachés derrière un seul T2M dégradé.
Si le T2M est élevé mais le Lead Time faible, le goulot d’étranglement se situe en amont de l’ingénierie. L’équipe sait exécuter, mais le travail reste coincé en analyse, attend une partie prenante, patiente derrière une décision de priorisation qui n’a pas été prise. Recruter plus d’ingénieurs n’aidera pas : ils seront simplement inoccupés d’une autre manière. Le travail consiste à réparer le pipeline de Discovery : qui décide de ce qui est prêt, à quel rythme, avec quelles informations.
Si le Lead Time est élevé, le problème se trouve dans la Delivery elle-même. Les tâches bloquent une fois que l’équipe les a prises : au développement, en revue, en QA, au déploiement. Il faut regarder à l’intérieur du Lead Time et identifier précisément où le temps passe.
En pratique, la plupart des équipes avec lesquelles je travaille ont des problèmes des deux côtés, mais rarement dans les mêmes proportions. La première chose que fait la séparation entre T2M et Lead Time, c’est de vous dire quelle conversation mener en premier. Côté Discovery, c’est généralement une conversation avec le fondateur, le product manager et la personne qui porte la priorisation. Côté Delivery, c’est une conversation avec l’engineering manager et l’équipe. Confondre les deux est l’un des moyens les plus sûrs d’appliquer le mauvais remède.
À l’intérieur du Lead Time, « travailler sur une tâche » et « la tâche est en cours de traitement » se révèlent être deux choses différentes, et c’est là que ça devient intéressant.
3. Lead Time = attente + Cycle Time
La plupart des équipes pensent qu’une fois une tâche « prête pour le développement », le vrai travail a commencé. Ce n’est pas le cas. La tâche est posée sur un tableau. Un développeur est occupé par la précédente. Quelqu’un est en congé. Un bug plus prioritaire passe devant. Le ticket reste là. Du point de vue du tableau, la tâche est « en cours ». Du point de vue du système, elle attend.
C’est pourquoi le Lead Time seul manque de précision. Il faut séparer le temps où l’on travaille réellement sur une tâche du temps où elle dort dans une file. La métrique que j’utilise pour cela est le Cycle Time : le temps entre le moment où une tâche est réellement prise en main et celui où elle est terminée. Uniquement le travail réel.
Mis bout à bout :
Lead Time = attente + Cycle Time
Cycle Time = travail, uniquement
Deux nouvelles questions de diagnostic en découlent.
Si le Cycle Time est élevé, le problème se trouve dans le développement lui-même. Une fois qu’on y travaille, la tâche met du temps à se terminer. Le goulot d’étranglement est dans l’exécution : complexité du code, revues qui traînent, tests instables, cycles de QA manuels, déploiements pénibles. C’est là que vous commencez à chercher avec l’équipe.
Si le Cycle Time est faible mais le Lead Time élevé, l’équipe va bien. L’exécution va bien. Le système reçoit plus de travail qu’il ne peut en traiter. Les tâches s’empilent dans la file et attendent que l’équipe finisse le lot précédent avant même de pouvoir être commencées.
C’est ce second cas qui prend les fondateurs au dépourvu. L’équipe avance vite sur chaque tâche prise isolément. Le tableau, lui, semble figé. Le réflexe est de pousser sur le débit individuel, alors que le vrai problème oppose la demande en amont à la capacité de l’équipe. La bonne conversation porte ici sur deux options : ajouter de la capacité de façon ciblée, ou limiter la quantité de travail que l’équipe accepte en même temps. Nous y reviendrons.
Tableau de diagnostic rapide pour un premier échange avec la direction :
| Ce que montre la métrique | Ce que cela signifie |
|---|---|
| Cycle Time élevé | Problème d’exécution : regardez dans le développement. |
| Lead Time élevé, Cycle Time normal | La demande dépasse la capacité. |
| Cycle Time faible, Lead Time faible, T2M élevé | Le goulot d’étranglement est dans la Discovery. |
Cela fait trois chiffres. Vous pouvez tous les extraire de Jira ou de Linear en un après-midi, et ils raconteront déjà une autre histoire que « il faut recruter ».
4. Où le travail bloque vraiment : pourquoi le temps par statut peut tromper
Le Cycle Time est donc élevé. Le réflexe naturel est de regarder à l’intérieur : mesurer le temps passé dans chaque statut. In Progress, Code Review, QA, Deploy. Additionner les heures. Trouver la colonne la plus lente. La réparer.
C’est ce que font la plupart des équipes, et cela fonctionne, jusqu’à un certain point. Si vos tâches bloquent en revue de code, vous pouvez lire le temps passé dans la colonne et ouvrir une vraie discussion sur la charge des relecteurs, la taille des PR, le délai de revue attendu. Même chose pour les goulots en QA, même chose pour les files de déploiement. Les données sont réelles et l’intervention est ciblée.
Mais il y a un piège, et je veux être précis à son sujet.
Les tâches ne traversent pas les étapes de façon linéaire. Elles reviennent en arrière : de la QA au développement quand un bug est trouvé, de la revue au développement quand un commentaire tombe, du déploiement au développement quand quelque chose échoue en staging. La même tâche traverse la même étape deux, trois, parfois cinq fois. Dès que vous mesurez le « temps moyen en QA », cette moyenne mélange en silence des tickets à leur premier passage et d’autres à leur troisième retour en QA.
À ce stade, la plupart des équipes redoublent d’efforts sur la mesure. Des tableaux de bord plus détaillés. Le suivi de chaque transition. Des métriques sur le « taux d’échec en QA au premier passage » et les « retours de revue par ticket ». Des rapports Jira sur mesure. Vous finissez avec un magnifique instrument dont personne ne peut rien tirer, parce que les données se sont compliquées plus vite que le système ne s’est éclairci.
L’erreur est de mesurer le système au mauvais niveau. L’optimisation locale, qui consiste à accélérer chaque colonne, suppose que le travail s’écoule de façon linéaire. Ce n’est pas le cas. Le système est un flux, avec ses remous, ses boucles et ses files d’attente.
Ce qui aide vraiment, c’est d’arrêter de vouloir mesurer chaque étape plus précisément et de regarder comment le travail circule dans le système dans son ensemble. La bonne question devient : « combien de tickets se trouvent dans le système en même temps, et quelle part avance réellement plutôt que d’être simplement retenue ? » Une fois cette question posée, le reste du diagnostic se simplifie beaucoup.
5. Comment trouver les goulots d’étranglement sans mesurer le temps
Voici le geste de diagnostic le plus sous-estimé que je connaisse.
Pas besoin de mesurer le temps passé dans chaque statut pour trouver le goulot d’étranglement. Il suffit de compter les tâches dans chaque statut.
Sortez ces chiffres de Jira en cinq minutes. La forme ressemble presque toujours à ceci :
Cherchez ensuite les déséquilibres.
Si vous avez cinq tâches en développement, trois en revue et vingt-cinq en QA, vous n’avez pas besoin de chronomètre. Ni d’un tableau de bord Looker. Le goulot, c’est la QA : les tâches s’y entassent. Le système a un endroit où le travail s’accumule plus vite qu’il ne s’écoule.
Ce simple comptage vous apprend presque tout ce que vous apprendrait le temps par statut, pour environ un pour cent de l’effort. Il fonctionne parce que les files d’attente sont la face visible d’un problème de flux : là où elles se forment, la capacité du système atteint son plafond.
Il recadre aussi la conversation. Le temps par statut invite à débattre de « combien de temps en QA, c’est trop ». Le comptage rend le problème évident : vingt-cinq tâches qui attendent deux ingénieurs QA, c’est un problème de système, et l’équipe QA n’y peut rien en travaillant plus vite.
C’est le diagnostic le moins cher et le plus rapide de tout le guide, et la plupart des équipes passent devant sans s’arrêter, pressées de construire des tableaux de bord dont elles ne se serviront jamais.
Mais il soulève une question plus profonde. Pourquoi vingt-cinq tâches sont-elles en QA ? D’où viennent-elles ? Pourquoi l’équipe continue-t-elle d’accepter du nouveau travail alors qu’un mur de tickets inachevés encombre déjà le système ?
6. Le travail en cours (WIP) : la variable qui pilote la vitesse de livraison
Six ingénieurs. Quatre-vingts tâches en cours. Rien n’aboutit.
Ce n’est pas une exagération. J’ai vu exactement cette configuration à plusieurs reprises. Une équipe de trois développeurs, deux ingénieurs QA et un tech lead : plus de quatre-vingts tickets actifs au tableau. Pour une équipe de six.
L’histoire est toujours la même. Un développeur termine la partie active d’une tâche et l’envoie en revue. Son ticket est désormais bloqué par quelqu’un d’autre. Plutôt que d’attendre, il en prend un autre dans le backlog. Celui-là se bloque aussi, en attente de la QA. Il en prend un autre. Le tableau se remplit de tâches techniquement « en cours », qui en réalité attendent quelqu’un d’autre, ailleurs, pour une autre raison.
C’est le travail en cours (WIP, Work in Progress) : le nombre de tâches que le système porte à un instant donné.
L’équipe ne peut matériellement pas travailler sur quatre-vingts choses à la fois. Six personnes, quatre-vingts tâches. L’essentiel du travail dort. En attente de revue, bloqué en QA, mis de côté parce qu’une partie prenante n’a pas répondu, en partie fait et fusionné mais pas encore déployé. Chacun de ces tickets occupe une place dans le système : une place dans la tête de quelqu’un, une place au tableau, un état dont quelqu’un doit entretenir le contexte.
Le coût s’accumule :
- Les tâches perdent leur pertinence métier pendant qu’elles attendent. Quand l’équipe y revient, les exigences ont bougé ou l’urgence s’est évaporée.
- Les conflits de fusion s’accumulent. Une branche de fonctionnalité qui dort trois semaines pendant que la branche principale avance devient un petit chantier archéologique à intégrer.
- Les changements de contexte coûtent cher. Chaque développeur garde en tête trois ou quatre tâches « en cours » à la fois. Aucune n’avance réellement.
- Les bugs passent plus facilement. Avec plus de travail en cours, chaque élément reçoit moins d’attention. La qualité baisse.
Et les métriques le confirment. Un WIP élevé va de pair avec un T2M élevé (les tâches mettent plus de temps à sortir), un débit faible (moins de tâches terminées par semaine), plus de bugs (moins d’attention par tâche) et un NPS plus bas, côté clients comme côté équipe.
C’est la variable qui pilote le système : la quantité de travail que l’équipe essaie de mener de front.
7. La loi de Little : Lead Time = WIP / débit
Si vous avez l’impression que les sections précédentes reviennent toujours à la même conclusion, vous avez raison. Il y a une raison à cela.
La recherche opérationnelle l’a établi il y a des décennies. La relation entre la quantité de travail dans un système et le temps que ce travail met à en sortir est donnée par la loi de Little :
Lead Time = WIP / débit
Dans le langage de la livraison logicielle :
- WIP : combien de tâches se trouvent dans le système en même temps
- Débit : combien de tâches l’équipe termine par période
- Lead Time : combien de temps une tâche vit dans le système, en moyenne
La formule est d’une simplicité presque gênante, et sa conséquence est brutale.
À débit constant, augmentez le WIP, et le lead time augmente proportionnellement. Exemple chiffré : une équipe qui termine dix tâches par semaine.
10 tâches dans le système → lead time moyen ≈ 1 semaine
30 tâches → ≈ 3 semaines
80 tâches → ≈ 8 semaines
L’équipe travaille à la même vitesse dans les trois scénarios. Les ingénieurs ne sont pas plus lents. Les tickets ne sont pas plus complexes. La seule chose qui a changé, c’est le nombre de tâches que le système essaie de porter simultanément. Et le lead time moyen a été multiplié par 8.
C’est pourquoi les équipes qui travaillent plus dur ne livrent pas forcément plus vite. À force d’efforts, vous pouvez gagner 10 à 20 % de débit. Avec de la discipline, vous pouvez réduire le WIP de 50 % ou plus. Les maths disent que le second levier pèse plus sur les résultats.
C’est aussi pourquoi « il nous faut plus d’ingénieurs » aggrave si souvent les choses. Les nouveaux ingénieurs apportent leur propre travail en cours. Le WIP augmente plus vite que le débit, et le lead time se dégrade avant de s’améliorer. L’onboarding le rend presque inévitable : les recrues mettent six à huit semaines à contribuer vraiment, et pendant ce temps, le WIP de l’équipe existante augmente (mentorat, transmission du contexte, revue des PR des nouveaux).
Si vous ne retenez qu’une formule, retenez celle-ci : Lead Time = WIP / débit.
C’est la mécanique du système derrière presque toutes les conversations du type « on avance trop lentement » que j’ai eues avec des équipes d’ingénierie.
8. Les limites de WIP : le levier qui répare la plupart des équipes lentes
Si le WIP est la variable qui pilote la vitesse du système, et qu’on peut rarement changer le débit de façon spectaculaire à court terme, le levier est évident : limiter le WIP.
Derrière le problème de productivité de la plupart des équipes d’ingénierie se cache un problème de WIP. Réglez le WIP, et la plupart des autres symptômes (lead times longs, bugs fréquents, faible prévisibilité, changements de contexte permanents) s’améliorent en même temps.
Les limites de WIP sont une discipline qui consiste à dire : ce système ne portera pas plus de N tâches à la fois. Si le WIP atteint la limite, aucun nouveau travail ne commence tant qu’un travail existant n’est pas terminé. Point.
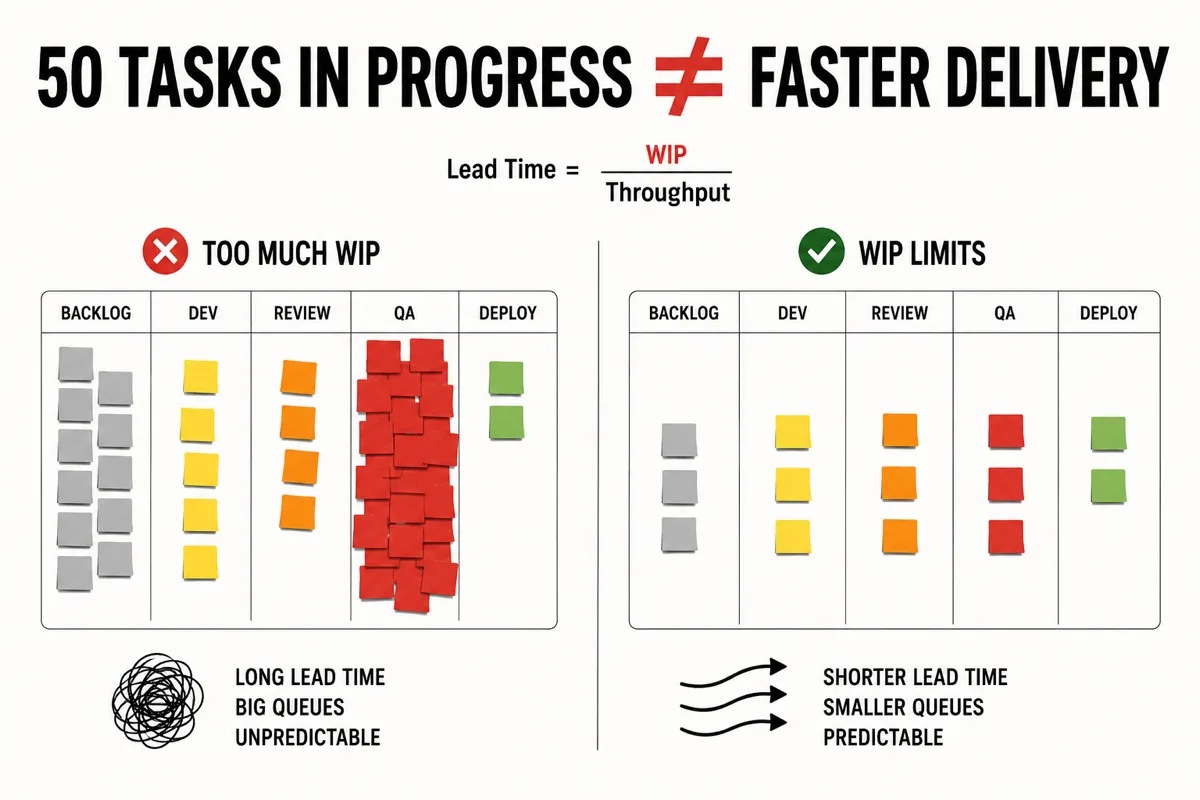
Ce que les limites de WIP améliorent concrètement :
- Moins de changements de contexte, parce que chacun porte moins de choses en parallèle
- Des files plus courtes à chaque étape, parce qu’il y a moins de travail dans le système
- Un Lead Time plus court, mécaniquement, par la loi de Little
- Moins de bugs, parce que l’attention se concentre sur finir plutôt que sur démarrer
- Plus de prévisibilité, parce que le système cesse d’osciller entre sous-charge et blocage
Ce que les limites de WIP ne font pas, et c’est ce qui déroute la direction, c’est accélérer chaque développeur individuellement. Elles accélèrent le système. L’équipe ne produit pas plus de code par heure-personne. Elle produit simplement moins de morceaux de code à moitié finis en parallèle, ce qui veut dire qu’une plus grande part de ce qu’elle produit arrive réellement en production.
C’est aussi l’un des très rares leviers qui améliorent la livraison sans recrutement, sans nouvel outil et sans refonte des processus. Il ne coûte rien. Il peut s’appliquer dès cette semaine. Et presque personne ne l’actionne, parce qu’il exige de dire « non » au démarrage de nouveaux travaux, et dire « non » à une partie prenante qui demande une chose de plus en parallèle est plus difficile que dire « oui ».
Les limites de WIP sont avant tout une affaire de discipline : celle d’une équipe et de ses parties prenantes capables de finir avant de commencer.
9. Introduire des limites de WIP sans révolte de l’équipe
Les maths sont une chose. Convaincre le système de les adopter en est une autre. Les équipes qui ont lu des choses sur les limites de WIP, ont essayé de les mettre en place, puis ont discrètement abandonné sont nombreuses. La majorité, je dirais.
Voici comment ça échoue. Quelqu’un, généralement l’engineering manager ou un ingénieur senior qui a lu le livre sur Kanban, annonce : « à partir de lundi, la limite de WIP est de 5 par développeur, sans exception. » Deux semaines plus tard, il n’en reste rien. Les raisons de l’échec sont prévisibles :
- Les développeurs voient leurs collègues bloqués en revue ou en QA, refusent de « rester les bras croisés » tant qu’il reste du travail dans le backlog, et commencent quand même de nouveaux tickets en douce
- Une partie prenante a besoin d’un sujet urgent, l’engineering manager subit la pression d’en haut, la limite est suspendue « juste pour cette fois »
- La direction passe devant l’équipe, voit des gens qui ne tapent pas visiblement sur leur clavier, et demande pourquoi l’équipe n’est pas pleinement utilisée
Les limites de WIP s’installent quand on les présente comme un changement de focus. Presque personne, ni chez les développeurs ni à la direction, ne trouve la règle intuitive en elle-même. Vu de l’extérieur, dire à un développeur de ne pas prendre de nouveau travail paraît irrationnel. C’est une posture qui va à rebours d’une culture qui récompense le fait de lancer des choses.
Je commence donc rarement par la limite elle-même. Je commence par déplacer le focus de l’équipe, de démarrer vers finir. La limite s’intègre une fois ce changement de focus acquis.
La séquence que j’utilise, dans les grandes lignes :
- Rendre l’objectif explicite. L’objectif est de finir le travail déjà commencé. Répétez-le régulièrement. Imprimez-le sur un autocollant. Tout ce qu’il faut pour que le message s’installe.
- Expliquer pourquoi. Montrez la loi de Little à l’équipe. Montrez-lui le diagnostic par comptage des tâches par statut. Argumentez avec les maths du système : on suit bien mieux une pratique qu’on comprend qu’une règle imposée par l’autorité.
- Montrer des exemples réels. Citez des cas où l’introduction de limites de WIP a visiblement changé le système : vos propres équipes passées, des articles comme celui-ci, des retours d’expérience d’autres équipes. La reconnaissance de situations vécues fait l’essentiel du travail que les exhortations n’arrivent pas à faire.
- Ramener le focus, souvent. Chaque fois que quelqu’un s’apprête à prendre une nouvelle tâche, demandez : « que peux-tu faire maintenant pour faire avancer un travail existant jusqu’au bout ? » Débloquer un coéquipier. Faire une revue. Répondre à une question de la QA. Résoudre à deux un conflit de fusion qui traîne. L’instinct de l’équipe est de prendre du travail neuf ; la discipline consiste à rediriger cet instinct.
Un commentaire sous l’un de mes propres posts racontait une histoire qui résume bien tout cela. Une équipe avait fixé WIP = 5. Au début, les parties prenantes y ont vu un échec : trop peu de choses visiblement en cours en même temps. En un trimestre, la vitesse de livraison s’était améliorée, la qualité aussi, la collaboration aussi, la prévisibilité aussi. Le regard des parties prenantes s’est inversé. Elles ont cessé de demander « pourquoi si peu de choses en cours ? » pour demander « pourquoi n’utilisons-nous pas des limites de WIP ailleurs dans l’entreprise ? »
Le plus difficile est généralement le management, qui assimile taux d’occupation et productivité. Si tout le monde dans l’équipe est « occupé à 100 % », le management est rassuré ; si quelqu’un est visiblement entre deux tickets, l’alarme sonne. La vérité, inconfortable, est qu’une équipe occupée à 100 % livre presque toujours moins qu’une équipe occupée à 80 %. C’est la marge dans le système qui permet au travail de s’écouler.
Les limites de WIP n’ont pas besoin d’un formalisme Kanban. Inutile d’afficher des chiffres sur le tableau. Il suffit que l’équipe et ses parties prenantes s’accordent, dans les faits : on finit avant de commencer.
10. La vue d’ensemble du système : vitesse, valeur et durabilité de la livraison
La vitesse seule ne donne pas une image complète. Tout cadre de métriques d’ingénierie qui n’optimise que la vitesse finira par casser quelque chose de plus important.
Le modèle de diagnostic complet a trois dimensions :
La vitesse du système : à quelle vitesse nous livrons des changements.
- T2M (Time to Market) : le temps total de l’idée à la production
- Débit : les tâches terminées par période
- Lead Time, Cycle Time, WIP : la décomposition que nous avons déjà parcourue
La valeur du produit : ce que nous livrons est-il vraiment utile.
- Qualité : bugs ouverts, taux de régression, taux d’incidents
- NPS / satisfaction client : l’utilisateur a-t-il le sentiment que le produit s’améliore
La durabilité de l’équipe : l’équipe peut-elle continuer à fonctionner ainsi.
- eNPS (Employee NPS) : l’équipe recommanderait-elle de travailler ici
- Signaux d’épuisement, taux de départ, charge d’astreinte
Les trois comptent, ensemble, parce que deux d’entre elles peuvent toujours être artificiellement gonflées au détriment de la troisième. Vous pouvez livrer plus vite en sautant la QA et en épuisant l’équipe : la vitesse monte, la valeur et la durabilité s’effondrent. Vous pouvez peaufiner la qualité jusqu’à la perfection sans rien livrer : la valeur par fonctionnalité monte, mais l’équipe et l’entreprise stagnent. Vous pouvez garder l’équipe heureuse et désœuvrée : la durabilité est excellente, la vitesse est nulle.
Un système de livraison qui fonctionne maintient les trois dimensions en tension. Il est assez rapide pour que l’entreprise reste compétitive, assez utile pour que les clients restent, et assez durable pour que l’équipe soit encore là l’an prochain. Quand des fondateurs me demandent à quoi ressemble un « bon » système, voici la réponse : trois chiffres qui évoluent à peu près ensemble.
L’eNPS, en particulier, est souvent négligé parce qu’il paraît plus flou que le reste. C’est pourtant le système d’alerte précoce de tout le reste. Une équipe dont l’eNPS baisse commencera, d’ici trois à six mois, à perdre ses seniors. Leurs remplaçants seront des juniors qu’il faudra faire monter en compétence. Le WIP augmentera, la connaissance s’amincira, la qualité baissera, les bugs se multiplieront. La métrique qui avait bougé en premier était celle que vous aviez ignorée.
Vous pouvez calculer presque tout cela à partir de Jira et d’un sondage RH régulier. Aucun outil spécial n’est nécessaire. Il faut seulement accepter de regarder le système avec honnêteté, dans ses trois dimensions à la fois.
Quand les métriques deviennent un outil de diagnostic
Les métriques ne sont pas nouvelles. Les idées non plus : la théorie des contraintes (années 1980), le Toyota Production System (années 1950), la méthode Kanban appliquée au logiciel (David Anderson, années 2000) et la loi de Little (1961) décrivent toutes différents aspects d’un même problème de fond : le travail circule dans des systèmes, et les systèmes ralentissent quand le flux se casse. Ce qui change, c’est l’usage qu’en fait votre équipe : un rapport ou un outil de diagnostic. Un rapport vous dit que quelque chose est cassé. Un diagnostic vous dit où.
Quand les livraisons sont lentes, la tentation est de réagir au rapport : recruter des ingénieurs, ajouter du processus, installer un nouvel outil. La réaction ressemble à du mouvement ; le progrès, lui, commence quand les métriques deviennent assez précises pour désigner la vraie contrainte.
Si vous avez sous les yeux un tableau avec 60 à 80 tâches actives pour une équipe de six, comptez les tâches par statut. Mesurez le Lead Time et le Cycle Time. Regardez la relation entre le WIP et le débit. Les maths du système feront l’essentiel du travail.
Questions fréquentes
Quelle différence entre Lead Time et Cycle Time ?
- Lead Time
- Le temps total qu’une tâche passe dans le développement, de « prête pour le développement » à « en production ». L’attente comprise.
- Cycle Time
- Uniquement la part de travail actif, de « réellement prise en main » à « terminée ». Sans l’attente.
L’écart entre les deux mesure la profondeur de la file d’attente.
Quelle limite de WIP est raisonnable pour une équipe de N personnes ?
Les recommandations du secteur vont de 1 à 3 tâches par développeur ; les équipes de développement logiciel se situent généralement dans le bas de la fourchette, 1 à 2 par développeur.
Équipe de 6 → environ 6 à 12 tâches actives dans tout le système, et certainement pas 80.
Le chiffre exact compte moins que la discipline d’en avoir un et de le faire respecter : la plupart des équipes trouvent leur bon niveau en commençant serré, puis en relâchant si le travail cale régulièrement pour des raisons étrangères au WIP.
En quoi est-ce différent de la capacité de sprint en Scrum ?
- Capacité de sprint
- La quantité de travail sur laquelle l’équipe s’engage pour une période de deux semaines.
- Limite de WIP
- La quantité de travail en cours à un instant donné, indépendamment du sprint.
Une équipe peut avoir un engagement de sprint raisonnable et mener malgré tout plus de 60 tâches en parallèle : la capacité de sprint ne dit rien sur le fait que le travail soit terminé ou seulement commencé. Les limites de WIP sont indépendantes de la planification de sprint et règlent souvent des problèmes que la planification seule n’atteint pas.
Et si notre débit est réellement trop faible ?
Il arrive que le débit soit vraiment la contrainte. Si le WIP est déjà maîtrisé et que le Lead Time reste élevé, l’équipe n’a peut-être pas assez de capacité pour la demande.
Avant de recruter, vérifiez trois choses :
- Les tâches sont-elles trop grosses ?
- L’exécution elle-même est-elle lente ?
- L’équipe passe-t-elle beaucoup de temps sur autre chose que la livraison ? Support, incidents, réunions, charge opérationnelle.
Si tout cela est sain et que le débit reste en deçà de la demande, recruter est peut-être la bonne décision. Les limites de WIP aident surtout à distinguer un problème de capacité d’un problème de flux.