Livraison assistée par l’IA
L’IA a rendu le démarrage presque gratuit. Finir coûte toujours cher.
Les équipes dotées d’agents IA démarrent plus de travail que jamais et livrent à peu près autant qu’avant. Le démarrage est devenu bon marché ; la vérification, l’intégration et la mise en production ont gardé leur prix. La solution est une vieille discipline : limiter le travail en cours et compter ce qui est fini.
Démarrer un nouveau travail n’a jamais coûté aussi peu. Un fil d’agent de plus. Une idée de plus. Une expérience de plus qui tourne en arrière-plan. Le coût pour commencer quelque chose s’est effondré : un agent IA prend n’importe quelle tâche que vous lui donnez, immédiatement, à toute heure.
Ce qui ne s’est pas effondré, c’est le coût pour finir. Vérification, intégration, revue, déploiement : amener le travail au point où il tourne en production et rapporte coûte presque exactement ce que cela coûtait avant.
Les équipes démarrent donc plus que jamais et livrent à peu près autant. Les tableaux se remplissent de travail à moitié fait. Les agents tournent toute la journée, la facture de tokens grimpe, et pourtant les notes de version ne sont pas plus longues qu’au trimestre dernier.
C’est un vieux problème de flux, amplifié par de nouveaux outils, et sa solution est tout aussi ancienne : limiter le travail en cours et optimiser pour finir. Celui qui gagne, c’est celui qui termine le plus. La suite de cet article défend cette thèse : d’abord en argent, puis en mécanique.
Ce que coûte vraiment le travail assisté par l’IA, et comment le compter
Pendant des décennies, le coût d’une tâche est resté invisible, noyé dans des salaires fixes. Le mois d’un développeur coûte la même chose qu’une fonctionnalité ait demandé trois tentatives ou trente ; personne ne comptait donc les tentatives. Avec les agents IA, chaque action a un prix, et la comptabilité devient très visible, très vite.
Voici à quoi cela ressemble en pratique. Un agent a fait 40 tentatives, dépensé 15 $ en tokens, et n’a toujours pas livré de fonctionnalité qui marche. Multipliez maintenant par chaque tâche que votre équipe mène en un mois. La boucle derrière cette facture est familière à quiconque fait travailler des agents sur de vrais projets : une tentative. Ça marche presque. Encore une tentative. Un peu mieux. Puis quelque chose casse, le contexte dérape, vous commencez à corriger, et ça empire. Quelque part par là, vous le voyez clairement : une « tâche » est rarement une seule action. Ce sont des dizaines d’itérations (tentatives, corrections, impasses), et vous les payez toutes, y compris celles que vous jetez.
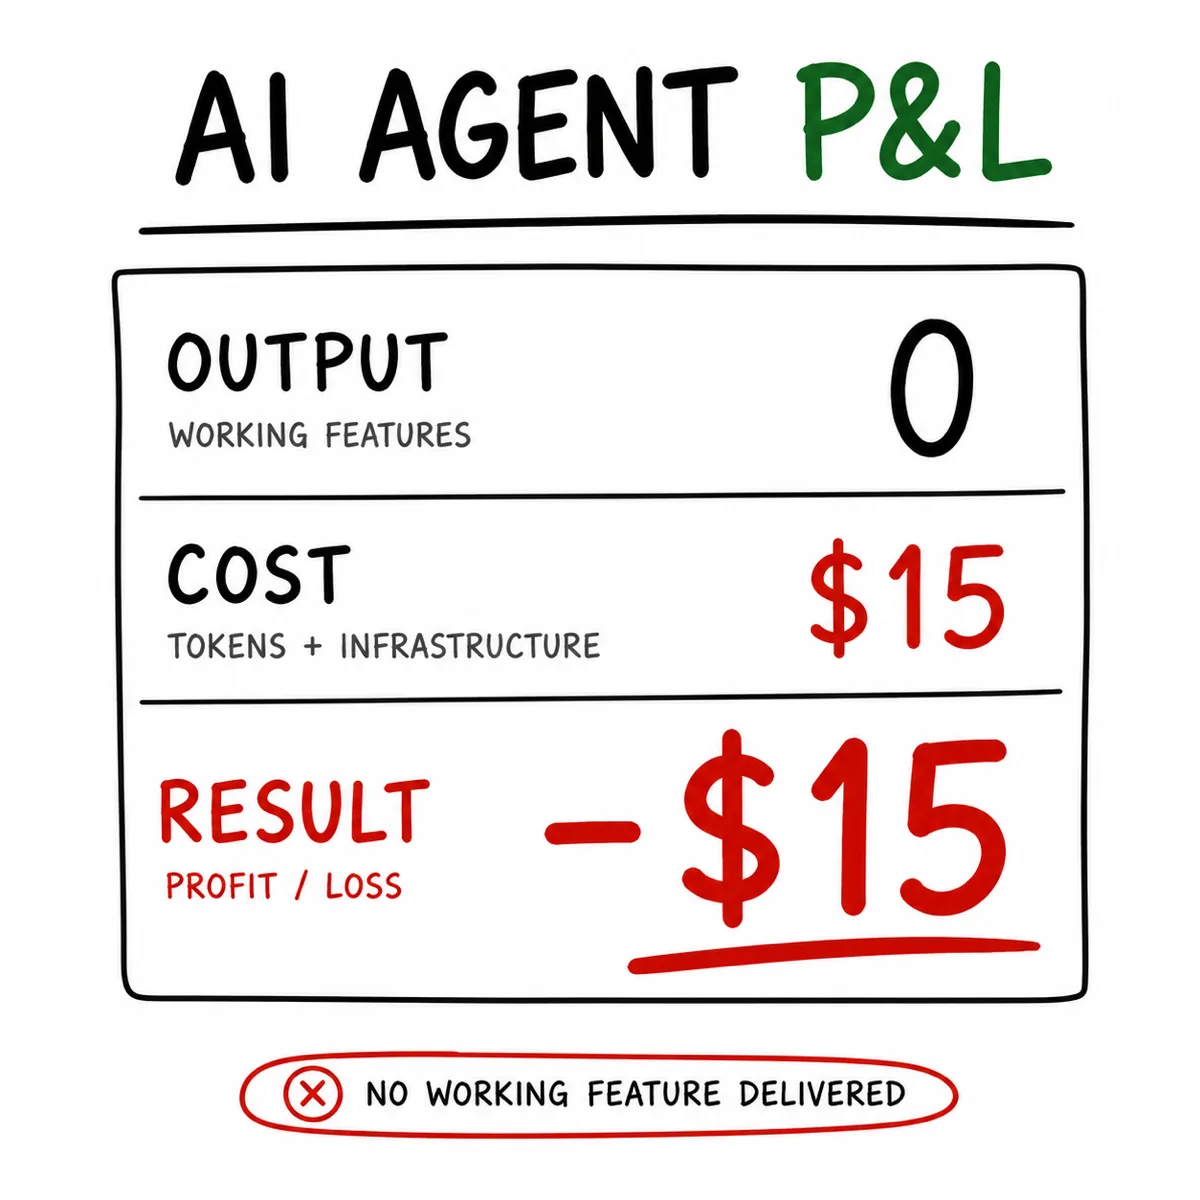
Pour savoir ce que coûtent réellement vos livraisons, il suffit de compter trois choses :
- combien de tâches ont abouti à un résultat qui fonctionne,
- combien d’itérations il a fallu,
- et combien ces itérations ont coûté.
Divisez la dépense totale par le nombre de tâches terminées, et vous obtenez le chiffre qui compte : le coût par tâche réussie, ce que vous coûte réellement un travail terminé.
L’optimisation cesse alors d’être une affaire de devinette. Le nouveau prompt aide-t-il vraiment ? Les tests autour de l’agent sont-ils rentables ? Ce changement de méthode a-t-il servi à quelque chose ? Subjectivement, tout « a l’air mieux », toujours. Le chiffre se moque des impressions : après chaque changement, le coût par tâche réussie a baissé, ou il n’a pas baissé.
Un avertissement avant de vous lancer dans l’optimisation. Observez des équipes travailler sur cette métrique : elles foncent sur le prix des tokens et le choix des modèles, et passent à côté de la vraie fuite. L’objectif est de maximiser les résultats obtenus pour chaque dollar dépensé. Et ce qui pèse le plus sur le coût par tâche terminée, c’est tout le travail que vous avez commencé sans jamais le finir, bien plus que le prix d’une itération.
Vos métriques de livraison s’appliquent toujours au travail assisté par l’IA
Si vous avez lu comment je diagnostique les systèmes de livraison, le cadre est le même ici. Toutes les métriques qui décrivaient une équipe humaine s’appliquent toujours. Une seule chose a vraiment changé :
| Métrique | Ce qui change avec les agents IA |
|---|---|
| Débit : tâches livrées par période | Rien. Ce qui compte, c’est la production. |
| Time to Market : de l’idée au résultat qui fonctionne | Rien. Le chronomètre court toujours jusqu’à la production. |
| Qualité : travail utilisable sans reprise | Rien. Ce sont toujours les reprises qui vous ruinent. |
| NPS : le résultat crée-t-il de la valeur | Rien. La valeur reste l’objectif. |
| Coût par tâche réussie : dépense totale ÷ tâches terminées | Tout. Il était invisible, noyé dans les salaires. Désormais, chaque tâche a sa facture. |
Vous pouvez livrer vite mais cher, pas cher mais noyé sous les reprises, ou beaucoup mais rien dont les utilisateurs ont besoin, et l’économie du projet cesse discrètement de tenir.
Le système de mesure a survécu. Ce qui a changé, c’est l’endroit où le travail s’accumule.
Pourquoi votre agent IA se dégrade à chaque tâche menée en parallèle
Deux mécanismes mangent les gains. Tous deux sont anciens ; tous deux ont été amplifiés.
Le premier, c’est l’attente. Dans la plupart des systèmes, la plupart des tâches ne sont pas en train d’être traitées : elles attendent. Regardez un flux de travail assisté par l’IA : vous attendez l’agent (génération, tests, déploiement), puis l’agent vous attend (une réponse, une décision, la consigne suivante). Pendant qu’une tâche attend, vous passez à une autre, puisque la démarrer ne coûte presque rien. Chaque tâche ajoutée allonge la file pour toutes les autres. La loi de Little (le lead time est égal au travail en cours divisé par le débit) se moque de savoir si le travail est fait par des humains ou par des agents. Démarrez plus sans finir plus, et chaque tâche vit simplement plus longtemps.
Le second, c’est le contexte. Tout système a une limite à la quantité de travail actif qu’il peut porter. Pour un humain, cette limite, c’est l’attention et la mémoire. Une étude sur le travail interrompu a montré que les gens compensent bien les changements de tâche, en travaillant plus vite, mais le paient par une charge de travail, un stress et une frustration nettement plus élevés (Mark, Gudith & Klocke, 2008). Le coût est réel ; il se cache simplement chez les humains au lieu de figurer sur la facture.
Pour un agent, la limite est la fenêtre de contexte, et là, la dégradation se mesure dans le résultat lui-même. Une étude sur des agents web confrontés à des tâches à long contexte (Chung et al.) a montré que les performances s’effondrent à mesure que de l’historique sans rapport s’accumule dans le contexte, exactement ce que produit un fil multitâche. Avec un bruit accumulé jusqu’à 150 000 tokens, les taux de réussite sont tombés de 40–50 % à moins de 10 % pour certains des modèles testés : GPT-4.1 est passé d’environ 45 % à 2,7 %.
Les humains perdent leur concentration, les agents perdent leur contexte : c’est la même défaillance. Trop de travail en cours dégrade celui qui travaille, qu’il soit fait de neurones ou de tokens.
Un fil, une tâche : des limites de WIP pour le travail assisté par l’IA
La discipline qui règle ce problème existe depuis des décennies. L’IA l’a rendue obligatoire, parce que la tentation de démarrer davantage n’a jamais été aussi bon marché.
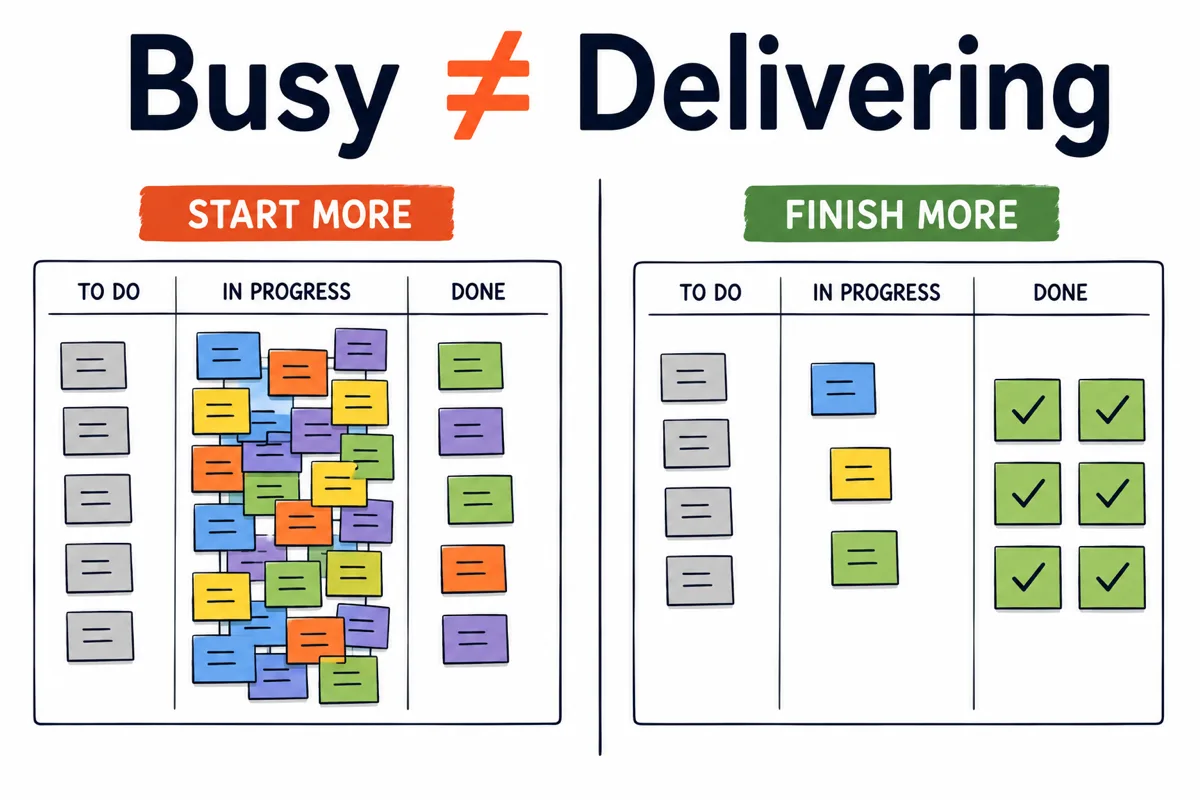
- Pour les agents : un fil, une tâche. Gardez chaque fil centré sur un seul résultat. Quand des sujets annexes surgissent, un bug repéré au passage, un refactoring qui vaudrait le coup, notez-les dans une liste ou confiez-les à un autre agent, hors de la conversation en cours. Un fil centré aboutit ; un fil surchargé tourne en rond.
- Pour vous : finir avant de démarrer. Avant d’ouvrir une nouvelle tâche, demandez-vous ce que vous pouvez clore. Un agent qui attend votre revue, c’est du travail en cours. Trois agents qui attendent votre revue, c’est une file d’attente, et le goulot d’étranglement, c’est vous.
- Pour l’équipe : les mêmes limites de WIP, pour les deux types de travailleurs. Le chiffre qui compte, c’est la quantité de travail inachevé présente dans le système. Une longue liste de fils actifs, c’est du stock.
Le changement inconfortable porte sur ce qui compte comme signe de progrès. Le travail démarré était rare, donc démarrer voulait dire quelque chose. Maintenant que démarrer ne coûte presque rien, celui qui gagne, c’est celui qui termine le plus. Moins de choses en cours, plus de choses terminées.
La contrainte s’est déplacée : suivez-la
Si vous adhérez à la thèse, finir avant de démarrer, une conséquence de plus en découle, et pour les startups qui misent beaucoup sur l’IA, c’est la plus importante.
Pour un fondateur seul ou une toute petite équipe qui utilise l’IA avec discipline, écrire du code a presque cessé d’être la contrainte. Les itérations coûtent peu comparées au coût du travail inachevé ; la génération elle-même est rapide. Ce qui est rare désormais, c’est la capacité à décider quoi construire, pourquoi et pour qui, et la capacité à mener le travail jusqu’au bout. Pour une équipe produit de 5 à 50 ingénieurs, coder n’est pas encore gratuit, mais la direction est la même : le goulot d’étranglement quitte la production de code pour aller vers les décisions et la finition.
C’est le b.a.-ba de la théorie des contraintes : quand la contrainte se déplace, optimiser l’ancienne est un effort perdu. Gagner encore 10 % sur la génération de code ne change rien si le travail meurt en attendant la vérification, la revue et une décision.
L’IA rend la pensée systémique plus nécessaire que jamais, car elle rend les erreurs de système plus coûteuses : la facture arrive désormais immédiatement, détaillée, en dollars. Si votre système de livraison perd du travail entre « démarré » et « livré », les agents se feront un plaisir de démultiplier cette perte. (Si c’est là que vous en êtes avec un produit construit par l’IA, j’ai décrit à part comment remettre un tel projet d’aplomb.)
Questions fréquentes
Pourquoi mon agent IA devient-il moins bon quand je lui confie plusieurs tâches à la fois ?
Parce que la mémoire de travail d’un agent, sa fenêtre de contexte, est une limite dure, et la recherche montre que les taux de réussite s’effondrent à mesure que du contexte sans rapport s’accumule dans un fil. Cinq tâches dans une même conversation, ce sont des détails brouillés et des décisions oubliées. Ouvrez un fil par tâche et envoyez le travail annexe ailleurs : vous livrerez davantage avec le même agent.
Le coût des tokens est-il le bon levier à optimiser ?
Rarement. Avec une hygiène de base, les tokens restent une ligne mineure du budget. Ce qui coûte cher, c’est le travail inachevé : les tâches qui ont consommé des itérations et sont mortes avant la production, et les files où du travail presque fini attend une revue. Optimisez d’abord le taux d’achèvement ; le prix des tokens viendra plus tard, si jamais il compte.
L’IA rend-elle les limites de WIP obsolètes ?
C’est l’inverse. Les limites de WIP existaient parce que démarrer était tentant et finir, difficile. L’IA a rendu le démarrage presque gratuit : la tentation est donc plus forte, et la limite d’autant plus précieuse. Et elle s’applique désormais à vos agents autant qu’à votre équipe.