Entrega com IA
A IA deixou começar quase de graça. Terminar continua caro.
Equipes com agentes de IA começam mais trabalho do que nunca e entregam mais ou menos o mesmo. Começar ficou barato; verificar, integrar e colocar em produção continua custando o mesmo. A saída é uma disciplina antiga: limitar o trabalho em andamento e contar o que foi terminado.
Começar um trabalho novo nunca foi tão barato. Mais uma thread com o agente. Mais uma ideia. Mais um experimento rodando em segundo plano. O custo de começar algo despencou: um agente de IA aceita qualquer tarefa que você passar, na hora, a qualquer hora.
O que continuou no mesmo lugar foi o custo de terminar. Verificação, integração, revisão, deploy: levar o trabalho até o ponto em que ele roda em produção e se paga custa quase exatamente o que custava antes.
Então as equipes começam mais do que nunca e entregam mais ou menos o mesmo. Os quadros se enchem de trabalho pela metade. Os agentes rodam o dia inteiro, a conta de tokens cresce, e, por algum motivo, as notas de release não ficam maiores que as do trimestre passado.
O que está por trás é um velho problema de fluxo, ampliado pelas ferramentas novas, e a solução também é antiga: limite o trabalho em andamento e otimize para terminar. Vence quem mais termina, por mais que outros comecem mais. O resto do artigo defende essa tese: primeiro em dinheiro, depois na mecânica.
Quanto custa de fato o trabalho com IA, e como contar
Por décadas, o custo de uma tarefa foi invisível, enterrado em salários fixos. Um mês de um desenvolvedor custa o mesmo, tenha a funcionalidade levado três tentativas ou trinta, então ninguém contava tentativas. Com agentes de IA, cada ação tem um preço, e a contabilidade fica muito visível, muito rápido.
Na prática, fica assim. Um agente fez 40 tentativas, gastou US$ 15 em tokens e mesmo assim não entregou uma funcionalidade funcionando. Agora multiplique isso por todas as tarefas que a sua equipe roda num mês. O ciclo por trás dessa conta é familiar para quem usa agentes em trabalho real: uma tentativa. Quase funciona. Mais uma tentativa. Um pouco melhor. Aí algo quebra, o contexto escapa, você começa a corrigir, e piora. Em algum ponto aí você enxerga com clareza: uma “tarefa” raramente é uma ação só. São dezenas de iterações (tentativas, correções, becos sem saída), e você paga por cada uma, inclusive pelas que joga fora.
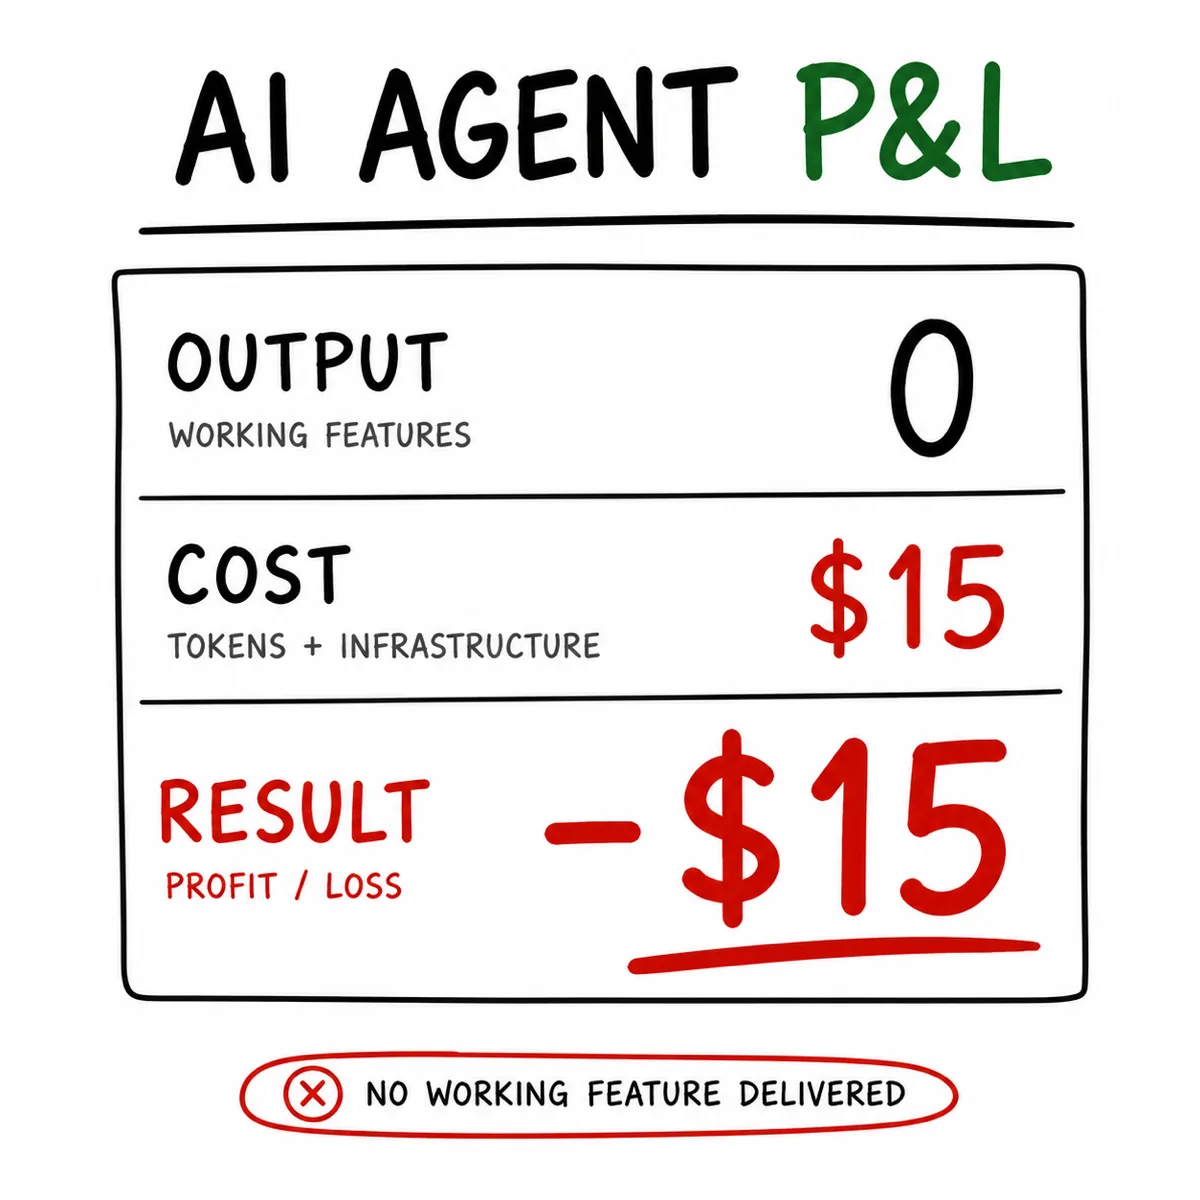
Para saber quanto as suas entregas realmente custam, basta contar três coisas:
- quantas tarefas chegaram a um resultado que funciona,
- quantas iterações isso exigiu,
- e quanto essas iterações custaram.
Divida o gasto total pelas tarefas concluídas e você tem o número que importa: o custo por tarefa bem-sucedida, ou seja, quanto uma peça de trabalho concluída realmente custa para você.
A recompensa é que otimizar deixa de ser chute. O prompt novo ajuda mesmo? Os testes em volta do agente se pagam? Aquela mudança no fluxo fez alguma diferença? Subjetivamente, tudo sempre “parece melhor”. O número ignora impressões: depois de qualquer mudança, o custo por tarefa bem-sucedida caiu ou não caiu.
Um aviso antes de você sair otimizando. Observe equipes trabalhando nessa métrica e você vai vê-las correr direto para o preço dos tokens e o nível do modelo, deixando passar o vazamento de verdade. O objetivo é maximizar os resultados bem-sucedidos por dólar gasto; economizar tokens vem bem depois. E o que mais pesa no custo por tarefa concluída é todo o trabalho que você começou e nunca terminou, bem mais do que o preço de uma iteração.
Suas métricas de entrega continuam valendo para o trabalho com IA
Se você leu como eu diagnostico sistemas de entrega, o modelo aqui é o mesmo. Toda métrica que descrevia uma equipe humana continua valendo. Só uma coisa mudou de fato:
| Métrica | O que muda com agentes de IA |
|---|---|
| Throughput: tarefas entregues por período | Nada. Conta o que chega à produção. |
| Time to Market: da ideia ao resultado funcionando | Nada. O relógio continua correndo até a produção. |
| Qualidade: trabalho que dá para usar sem retrabalho | Nada. O retrabalho continua sendo o que consome você. |
| NPS: se o resultado gera valor | Nada. O valor continua sendo o objetivo. |
| Custo por tarefa bem-sucedida: gasto total ÷ tarefas concluídas | Tudo. Antes era invisível, enterrado nos salários. Agora cada tarefa tem uma conta. |
Dá para entregar rápido e caro, barato e afogado em retrabalho, ou muito e nada do que os usuários precisam, e a conta discretamente para de fechar.
O sistema de medição sobreviveu. O que mudou é onde o trabalho se acumula.
Por que seu agente de IA piora a cada tarefa paralela
Dois mecanismos comem os ganhos. Os dois são antigos; os dois foram amplificados.
O primeiro é a espera. Na maioria dos sistemas, a maior parte das tarefas está esperando, e ninguém está trabalhando nelas. Agora olhe para um fluxo com IA: você espera o agente (geração, testes, deploy), depois o agente espera você (uma resposta, uma decisão, a próxima instrução). Enquanto uma tarefa espera, você passa para outra; afinal, começar é quase de graça. Cada tarefa que você adiciona alonga a fila para todas. A Lei de Little (lead time é igual ao trabalho em andamento dividido pelo throughput) vale do mesmo jeito para pessoas e para agentes. Comece mais sem terminar mais, e cada tarefa simplesmente vive mais tempo.
O segundo é o contexto. Todo sistema tem um limite de quanto trabalho ativo consegue segurar. Para uma pessoa, o limite é atenção e memória. Uma pesquisa sobre trabalho interrompido mostrou que as pessoas de fato compensam as trocas, trabalhando mais rápido, mas pagam com carga de trabalho, estresse e frustração mensuravelmente maiores (Mark, Gudith & Klocke, 2008). O custo é real; só que ele fica escondido nas pessoas em vez de aparecer na fatura.
Para um agente, o limite é a janela de contexto, e aí a degradação se mede no resultado. Um estudo com agentes web em tarefas de contexto longo (Chung et al.) mostrou que o desempenho desaba conforme o histórico irrelevante se acumula no contexto, exatamente o que uma thread com várias tarefas produz. Com o ruído chegando perto de 150 mil tokens, as taxas de sucesso caíram de 40–50% para um dígito em alguns dos modelos testados: o GPT-4.1 caiu de cerca de 45% para 2,7%.
Pessoas perdem o foco, agentes perdem o contexto, e a falha é a mesma. Trabalho demais em andamento degrada quem trabalha, seja feito de neurônios ou de tokens.
Uma thread, uma tarefa: limites de WIP para o trabalho com IA
A disciplina que resolve isso existe há décadas. A IA a tornou obrigatória, porque a tentação de começar mais nunca foi tão barata.
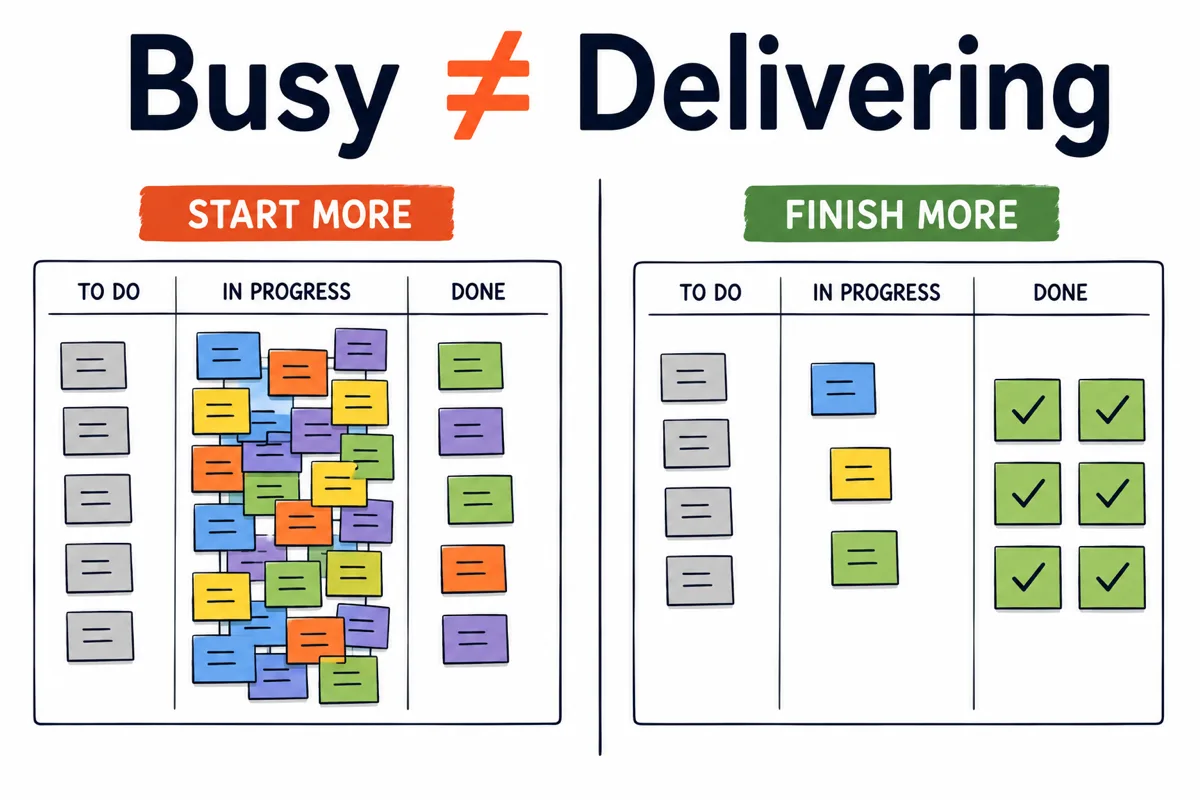
- Para os agentes: uma thread, uma tarefa. Mantenha cada thread focada num único resultado. Quando surgirem questões paralelas (um bug que você notou, uma refatoração que vale a pena), elas vão para uma lista ou para outro agente, e ficam fora da conversa atual. Uma thread focada termina; uma sobrecarregada anda em círculos.
- Para você: termine antes de começar. Antes de abrir uma tarefa nova, pergunte o que você consegue fechar. Um agente esperando a sua revisão é trabalho em andamento. Três agentes esperando a sua revisão são uma fila, e o gargalo dela é você.
- Para a equipe: os mesmos limites de WIP, para os dois tipos de trabalhador. O número que importa é quanto trabalho inacabado está parado no sistema; tarefas iniciadas e atividade dos agentes dizem pouco. Uma lista longa de threads ativas é estoque.
A mudança desconfortável está no que conta como sinal de progresso. Trabalho iniciado era escasso, então começar significava alguma coisa. Agora que começar é quase de graça, vence quem mais termina, por mais que outros comecem mais. Menos coisas em andamento, mais coisas prontas.
A restrição mudou de lugar, e você precisa ir atrás dela
Se você aceita a tese de que terminar vale mais que começar, segue mais uma consequência, e, para startups que usam muita IA, é a mais importante.
Para um fundador sozinho ou uma equipe pequena que usa IA com disciplina, escrever código quase deixou de ser a restrição. As iterações são baratas perto do custo do trabalho inacabado; a geração em si é rápida. O que ficou escasso é a capacidade de decidir o que construir, por que e para quem, e a capacidade de levar o trabalho até o fim. Para uma equipe de produto com 5 a 50 engenheiros, programar ainda tem custo, mas a direção é a mesma: o gargalo está saindo da produção de código e indo para as decisões e para a conclusão.
É o básico da Teoria das Restrições: quando a restrição muda de lugar, otimizar a antiga é esforço jogado fora. Espremer mais 10% da geração de código não muda nada se o trabalho morre esperando verificação, revisão e uma decisão.
Com a IA, o pensamento sistêmico continua valendo, e os erros de sistema ficam mais caros, porque agora a conta chega na hora, discriminada, em dólares. Se o seu sistema de entrega perde trabalho entre “começado” e “entregue”, os agentes vão escalar essa perda para você com todo o prazer. (Se é aí que você está com um produto construído com IA, escrevi sobre o caminho de resgate em outro texto.)
Perguntas frequentes
Por que meu agente de IA piora quando passo várias tarefas de uma vez?
Porque a memória de trabalho do agente, a janela de contexto, é um limite rígido, e pesquisas mostram as taxas de sucesso despencando conforme contexto irrelevante se acumula numa thread. Cinco tarefas numa conversa significam detalhes borrados e decisões esquecidas. Use uma thread por tarefa e mande o resto para outro lugar; você vai entregar mais com o mesmo agente.
O custo dos tokens é a coisa certa a otimizar?
Normalmente, não. Com uma higiene básica, os tokens são um item pequeno da conta. O que sai caro é o trabalho inacabado: tarefas que consumiram iterações e morreram antes da produção, e filas onde trabalho quase pronto espera revisão. Otimize primeiro a taxa de conclusão; o preço dos tokens fica para depois, se é que algum dia.
A IA torna os limites de WIP obsoletos?
Pelo contrário. Os limites de WIP existiam porque começar era tentador e terminar era difícil. A IA deixou começar quase de graça, o que aumenta a tentação e faz o limite valer ainda mais. E agora ele vale tanto para os seus agentes quanto para a sua equipe.