Entrega de software
Cómo diagnosticar dónde falla de verdad la entrega de software
Lo que frena a la mayoría de los equipos de desarrollo lentos es el flujo del trabajo; la productividad de las personas suele estar bien. Y la primera reacción de casi todo el mundo ante ese problema hace que el sistema vaya todavía más lento.
Este es un patrón que he visto muchas veces a lo largo de los años: un equipo de seis personas con 60–80 tareas activas en el tablero, lanzamientos que han pasado de días a semanas y luego a «ya lo haremos el mes que viene», y una conclusión muy razonable: más manos lo arreglarán. Normalmente el verdadero cuello de botella está en otra parte.
El diagnóstico descompone la línea temporal de una sola tarea, de la idea al usuario, hasta que puedes señalar la etapa concreta en la que el sistema deja de funcionar. Una vez que puedes señalarla, la solución suele ser evidente, y la mayoría de las veces no implica contratar a nadie. El orden de abajo reproduce un proyecto real: síntomas → descomposición → encontrar el cuello de botella → hablar de la palanca.
1. Síntomas de una entrega lenta y el primer reflejo equivocado
La primera conversación casi siempre empieza igual. El T2M se mide en meses. El throughput está cerca de cero. Hay más bugs en el tablero que tareas abiertas. El NPS del equipo, interno o externo, está entre malo y peor.
Los ingenieros trabajan, el engineering manager lo intenta, el product manager se deja la piel con el backlog. Y aun así, el primer reflejo, siempre, es «necesitamos más ingenieros». Y es el reflejo equivocado.
Te explico por qué. Cuando un programa falla, abrimos un depurador; a nadie se le ocurre añadir más desarrolladores al código fuente. Miramos en qué estado está el programa, dónde se queda atascado, qué hace realmente frente a lo que esperábamos. Con un sistema de ingeniería pasa lo mismo. Las métricas de arriba te dicen que el resultado es malo. No te dicen dónde se está rompiendo el sistema. Ampliar el equipo sin esa información solo hace el sistema más complejo (más traspasos, más trabajo en marcha, colas más largas) y casi siempre más lento.
Así que, antes de cualquier conversación sobre contratar, el trabajo consiste en descomponer el proceso en sus partes y encontrar dónde empieza a degradarse. Ese es el momento en que las métricas dejan de ser un boletín de notas y se convierten en una herramienta de diagnóstico.
2. Divide el T2M: Discovery y Lead Time son problemas distintos
Cuando una tarea aparece por primera vez, todavía es una idea en bruto: la petición de un cliente, un informe de bug, una hipótesis del fundador, algo que alguien notó en una reunión. Antes de que el equipo pueda construirla, alguien tiene que darle forma: aclarar qué significa de verdad, esbozar la solución, decidir si merece la pena, conseguir las aprobaciones necesarias. No todas las ideas superan esa etapa, y las que la superan no siempre lo hacen rápido.
Esa distancia es importante, porque ahí es donde muchos equipos pierden semanas sin darse cuenta. El T2M (Time to Market) es el tiempo total que va de la idea a producción. El primer corte útil es la frontera entre Discovery y Delivery.
Discovery es todo lo que ocurre antes de que un ticket esté realmente listo para que lo tome un desarrollador. Aclarar requisitos, diseño, acotar el alcance, alinear a los stakeholders, priorizar. El resultado: un ticket con el que alguien podría empezar a construir.
Delivery es todo lo que viene después, desde «listo para desarrollo» hasta «en producción». Es lo que miden implícitamente la mayoría de las métricas de ingeniería, y es la parte que el equipo controla directamente.
La métrica que uso para la segunda mitad es el Lead Time: el tiempo que un ticket pasa concretamente bajo la responsabilidad del equipo de desarrollo. Así que:
T2M = Discovery + Lead Time (Delivery)
Dos números, dos problemas muy distintos escondidos detrás de un mismo T2M roto.
Si el T2M es alto pero el Lead Time es bajo, el cuello de botella está antes de ingeniería. El equipo sabe ejecutar, pero el trabajo está parado en análisis, esperando a un stakeholder, en cola detrás de una decisión de prioridad que nadie ha tomado. Contratar más ingenieros no ayudará: simplemente estarán parados de otra manera. El trabajo consiste en arreglar el proceso de Discovery: quién decide qué está listo, con qué frecuencia y con qué información.
Si el Lead Time es alto, el problema está dentro del propio Delivery. Las tareas se atascan después de que el equipo las toma: en el desarrollo, en la revisión, en QA, en el despliegue. Hay que mirar dentro del Lead Time y averiguar en qué se va exactamente el tiempo.
En la práctica, la mayoría de los equipos con los que trabajo tienen problemas en los dos lados, pero rara vez en la misma proporción. Lo primero que hace la división entre T2M y Lead Time es decirte qué conversación tener primero. La de Discovery suele ser con el fundador, el product manager y quien sea responsable de las prioridades. La de Delivery es con el engineering manager y el equipo. Mezclar las dos es una de las formas más fiables de aplicar la solución equivocada.
Dentro del Lead Time, «trabajar en una tarea» y «que alguien esté trabajando en la tarea» resultan ser cosas distintas, y ahí es donde la cosa se pone interesante.
3. Lead Time = Espera + Cycle Time
La mayoría de los equipos creen que, en cuanto una tarea está «lista para desarrollo», el trabajo real ha empezado. No es así. La tarea se pone en el tablero. Un desarrollador está ocupado con la anterior. Alguien está de vacaciones. Un bug más prioritario se cuela. El ticket se queda ahí. Para el tablero, la tarea está «en curso». Para el sistema, solo está esperando.
Por eso el Lead Time por sí solo no es lo bastante preciso. Hay que separar el tiempo en que alguien trabaja de verdad en una tarea del tiempo en que solo espera en una cola. La métrica que uso para eso es el Cycle Time: el tiempo desde que alguien empieza de verdad con una tarea hasta que está terminada. Solo trabajo real.
Todo junto:
Lead Time = Espera + Cycle Time
Cycle Time = solo trabajo
De aquí salen dos preguntas de diagnóstico más.
Si el Cycle Time es alto, el problema está dentro del propio desarrollo. Una vez que la gente trabaja en una tarea, la tarea tarda en terminarse. El cuello de botella está en la ejecución: complejidad del código, retrasos en la revisión, tests inestables, ciclos de QA manual, despliegues dolorosos. Ahí es donde empiezas a mirar con el equipo.
Si el Cycle Time es bajo pero el Lead Time es alto, el equipo está bien. La ejecución está bien. Al sistema le llega más trabajo del que puede asumir. Las tareas se amontonan en la cola, esperando a que el equipo termine el lote anterior para poder siquiera empezar.
Este segundo caso es el que sorprende a los fundadores. El equipo avanza rápido en cada tarea individual. Y el tablero sigue pareciendo congelado. El instinto es apretar más el rendimiento individual, cuando el problema real es la demanda que llega frente a la capacidad del equipo. Aquí la conversación correcta trata de añadir capacidad de forma selectiva o de limitar cuánto trabajo acepta el equipo a la vez; acelerar al equipo queda fuera. Llegaremos a eso.
Tabla rápida de diagnóstico para la primera conversación con la dirección:
| Lo que muestra la métrica | Lo que significa |
|---|---|
| Cycle Time alto | Problema de ejecución: hay que mirar dentro del desarrollo. |
| Lead Time alto, Cycle Time normal | La demanda supera la capacidad. |
| Cycle Time bajo, Lead Time bajo, T2M alto | El cuello de botella está en Discovery; Delivery funciona. |
Son tres números. Puedes sacarlos todos de Jira o de Linear en una tarde, y ya te contarán una historia distinta de «tenemos que contratar».
4. Dónde se atasca de verdad el trabajo y por qué el tiempo por estado puede engañar
Así que el Cycle Time es alto. El siguiente paso natural es mirar dentro: medir el tiempo en cada estado. En curso, Code review, QA, Despliegue. Sumar en qué se van las horas. Encontrar la columna más lenta. Arreglarla.
Es lo que hacen la mayoría de los equipos, y funciona hasta cierto punto. Si tus tareas se atascan en la revisión de código, puedes leer el tiempo de esa columna y empezar una conversación real sobre la carga de los revisores, el tamaño de los PR, el plazo de revisión. Lo mismo con los cuellos de botella en QA, lo mismo con las colas de despliegue. Los datos son reales y la intervención es precisa.
Pero hay una trampa, y quiero ser concreto.
Las tareas no recorren las etapas en línea recta. Rebotan: de QA vuelven a desarrollo cuando aparece un bug, de la revisión vuelven al trabajo cuando llega un comentario, del despliegue vuelven a desarrollo cuando algo falla en staging. La misma tarea pasa por la misma etapa dos, tres, a veces cinco veces. En cuanto empiezas a medir el «tiempo medio en QA», esa media mezcla en silencio los tickets que pasan a la primera con su tercer rebote en QA.
Lo que hacen la mayoría de los equipos en este punto es redoblar la medición. Dashboards más detallados. Registrar cada transición. Añadir métricas como «tasa de fallos de QA a la primera» y «rebotes de revisión por ticket». Montar informes personalizados en Jira. Al final tienes un instrumento precioso con el que nadie puede actuar, porque los datos se han complicado más deprisa de lo que se ha aclarado el sistema que hay debajo.
El error es que intentas medir el sistema al nivel equivocado. La optimización local (hacer más rápida cada columna) supone que el trabajo fluye en línea recta. Y no es así. El sistema funciona como un flujo con remolinos, bucles y colas, muy lejos de un pipeline lineal.
El cambio que de verdad ayuda es dejar de intentar medir cada etapa con más precisión y empezar a preguntarse cómo se mueve el trabajo por el sistema en su conjunto. La pregunta pasa de «dónde se quedan más tiempo los tickets» a «cuántos tickets hay en el sistema a la vez, y qué proporción avanza de verdad frente a la que solo está ahí retenida». En cuanto te haces esa pregunta, el resto del diagnóstico se simplifica mucho.
5. Cómo encontrar cuellos de botella sin medir tiempos
Esta es la jugada de diagnóstico más infravalorada que conozco.
Para encontrar el cuello de botella basta con contar las tareas que hay en cada estado; medir el tiempo en cada estado sobra.
Saca los números de Jira en cinco minutos. La forma casi siempre se parece a esto:
Luego busca los desequilibrios.
Si tienes cinco tareas en desarrollo, tres en revisión y veinticinco en QA, no necesitas un cronómetro. No necesitas un dashboard en Looker. El cuello de botella es QA. Las tareas individuales pueden ir allí a buen ritmo; lo que pasa es que se acumulan en la cola. El sistema tiene un punto donde el trabajo se acumula más deprisa de lo que sale.
Este simple recuento te dice casi todo lo que te diría el tiempo por estado, con alrededor de un uno por ciento del esfuerzo. Funciona porque las colas son la parte visible de un problema de flujo: allí donde se forman colas, la capacidad del sistema está tocando techo.
Además cambia la conversación. El tiempo por estado invita a debatir «cuánto es demasiado tiempo en QA». El recuento de tareas deja el problema a la vista: veinticinco cosas esperando a dos ingenieros de QA es un problema del sistema, y pedir a QA que «trabaje más rápido» no lo resuelve.
Es el diagnóstico más barato y rápido de toda esta guía, y la mayoría de los equipos se lo saltan de camino a construir dashboards que nunca usarán.
Pero plantea una pregunta más profunda. ¿Por qué hay veinticinco tareas en QA? ¿De dónde salieron? ¿Por qué el equipo sigue aceptando trabajo nuevo cuando ya hay un muro de tickets sin terminar en el sistema?
6. Trabajo en curso (WIP): la variable que controla la velocidad de entrega
Seis ingenieros. Ochenta tareas en curso. No se termina nada.
No exagero. He visto exactamente esta forma varias veces. Un equipo de tres desarrolladores, dos ingenieros de QA y un tech lead, con más de ochenta tickets activos en el tablero. Para un equipo de seis.
La historia detrás siempre es la misma. Un desarrollador termina la parte activa de una tarea y la manda a revisión. Ahora su ticket está bloqueado por otra persona. En lugar de esperar, toma otro del backlog. Ese también se bloquea, esperando a QA. Toma otro. El tablero se llena de tareas que técnicamente están «en curso» pero que en realidad esperan a otra persona, en otro sitio, por algún otro motivo.
Esto es el trabajo en curso (WIP, Work in Progress): el número de tareas que el sistema sostiene en un momento dado.
El equipo no puede trabajar físicamente en ochenta cosas a la vez. Seis personas, ochenta tareas. La mayor parte del trabajo está simplemente parada. Esperando revisión, bloqueada en QA, aparcada porque un stakeholder no ha respondido, hecha a medias e integrada pero sin desplegar. Cada uno de esos tickets ocupa un hueco en el sistema: un hueco en el contexto mental de alguien, un sitio en el tablero, un trozo de estado que alguien tiene que mantener vivo.
El coste se multiplica:
- Las tareas pierden relevancia para el negocio mientras esperan. Cuando el equipo vuelve a ellas, los requisitos han cambiado o la urgencia se ha esfumado.
- Se acumulan los conflictos de merge. Una rama que pasa tres semanas parada mientras la rama principal sigue avanzando se convierte en un pequeño proyecto de arqueología a la hora de integrarla.
- Cambiar de contexto sale caro. Cada desarrollador lleva en la cabeza tres o cuatro tareas «en curso» a la vez. Ninguna avanza de verdad.
- Es más fácil que se cuelen bugs. Con más trabajo en marcha, cada pieza recibe menos miradas. La calidad baja.
Y las métricas lo confirman. Un WIP alto va de la mano de un T2M alto (las tareas tardan más en salir), un throughput bajo (se terminan menos tareas por semana), más bugs (menos atención por tarea) y un NPS más bajo, tanto de clientes como del equipo.
Esta es la variable que controla el sistema. Por encima de la velocidad del equipo y de la experiencia de los ingenieros: cuánto intentan sostener en marcha a la vez.
7. La ley de Little: Lead Time = WIP / Throughput
Si te parece que las secciones anteriores llegan una y otra vez a la misma conclusión, no te equivocas. Hay un motivo.
La investigación operativa lo resolvió hace décadas. La relación entre la cantidad de trabajo que hay en un sistema y lo que tarda ese trabajo la describe la ley de Little:
Lead Time = WIP / Throughput
En el lenguaje de la entrega de software:
- WIP: cuántas tareas hay en el sistema al mismo tiempo
- Throughput: cuántas tareas termina el equipo por periodo
- Lead Time: cuánto tiempo vive una tarea en el sistema, de media
La fórmula es casi vergonzosamente simple, y su consecuencia es brutal.
Mantén el throughput constante y aumenta el WIP: el lead time crece de forma lineal. Un ejemplo: un equipo que termina diez tareas por semana.
10 tareas en el sistema → lead time medio ≈ 1 semana
30 tareas → ≈ 3 semanas
80 tareas → ≈ 8 semanas
El equipo trabaja a la misma velocidad en los tres escenarios. Los ingenieros no son más lentos. Los tickets no son más complejos. Lo único que ha cambiado es cuántas tareas intenta sostener el sistema a la vez. Y el lead time medio se ha multiplicado por 8.
Por eso los equipos que trabajan más duro no necesariamente entregan más rápido. Con esfuerzo, puedes subir el throughput un 10–20 %. Con disciplina, puedes bajar el WIP un 50 % o más. Las matemáticas dicen que la segunda palanca mueve más los resultados.
También es la razón por la que «necesitamos más ingenieros» empeora las cosas tan a menudo. Los ingenieros nuevos traen su propio trabajo en marcha. El WIP sube más deprisa que el throughput, y el lead time empeora antes de mejorar. La incorporación lo hace casi inevitable: los recién llegados tardan de seis a ocho semanas en empezar a aportar de verdad, y durante ese tiempo el WIP del equipo actual aumenta (mentoría, traspaso de contexto, revisión de los PR del recién llegado).
Si te quedas con un solo número, que sea este. Lead Time = WIP / Throughput.
Son las matemáticas del sistema detrás de casi todas las conversaciones del tipo «vamos lentos» que he tenido en ingeniería.
8. Límites de WIP: la palanca que arregla a la mayoría de los equipos lentos
Así que, si el WIP es la variable que controla la velocidad del sistema y normalmente no podemos cambiar mucho el throughput a corto plazo, la palanca es evidente: limitar el WIP.
La mayoría de los equipos de ingeniería tienen un problema de productividad porque tienen un problema de WIP. Arregla el WIP, y la mayoría de los demás síntomas (lead times largos, bugs frecuentes, poca previsibilidad, cambios de contexto constantes) mejoran a la vez.
Los límites de WIP son la disciplina de decir: este sistema no sostendrá más de N tareas a la vez. Si el WIP está en el límite, no se empieza ningún trabajo nuevo hasta que termine algo de lo que ya existe. Punto.
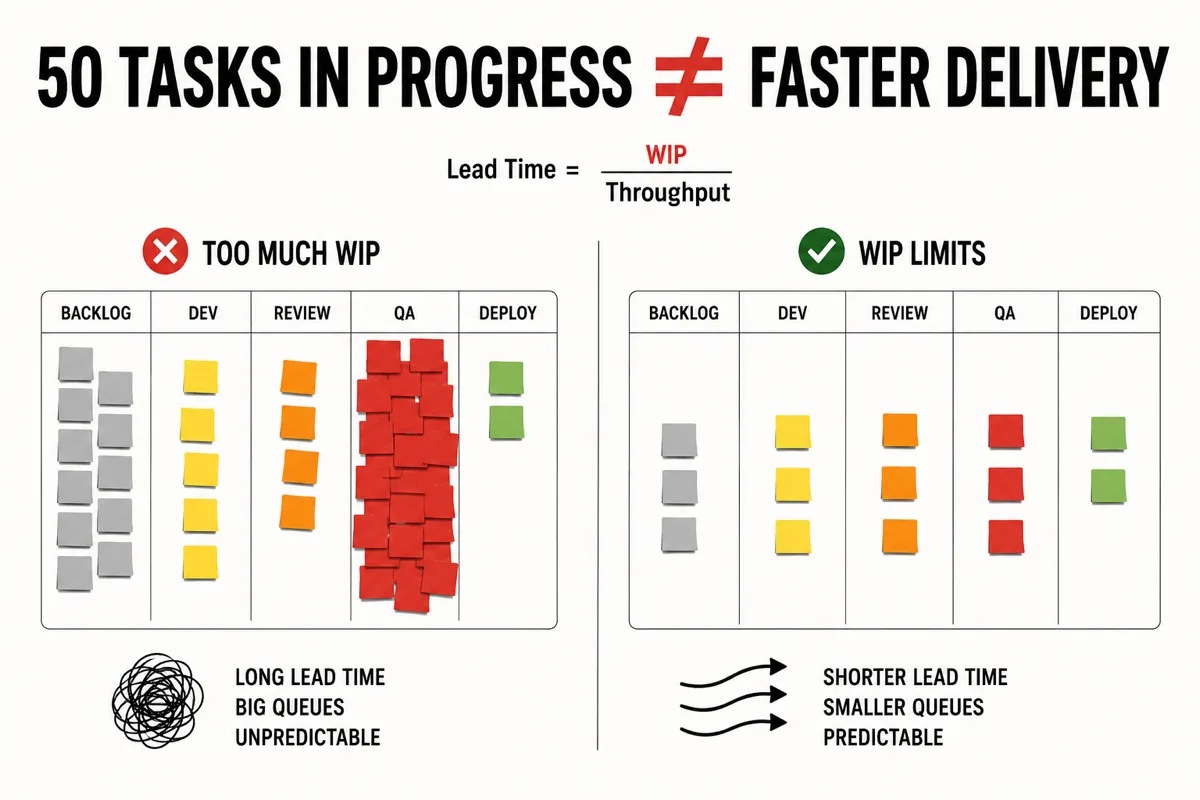
Lo que mejoran de verdad los límites de WIP:
- Menos cambios de contexto, porque cada persona lleva menos cosas en marcha
- Colas más cortas en cada etapa, porque hay menos trabajo en el sistema en total
- Un Lead Time más corto, por la ley de Little, de forma mecánica
- Menos bugs, porque la atención se concentra en terminar en lugar de empezar
- Más previsibilidad, porque el sistema deja de oscilar entre la infrautilización y el atasco
Los límites de WIP aceleran el sistema, y esta es la parte que confunde a la dirección: cada desarrollador sigue yendo a la misma velocidad. El equipo produce el mismo código por hora de trabajo; simplemente deja menos piezas de código a medias en paralelo, así que una parte mayor de lo que produce llega de verdad a producción.
Además, es una de las pocas palancas que mejoran la entrega sin contratar, sin herramientas nuevas y sin rediseñar procesos. No cuesta nada. Se puede aplicar esta misma semana. Y casi nadie lo hace, porque exige decir «no» a empezar trabajo nuevo, y decirle «no» a un stakeholder que pide una cosa más en marcha es más difícil que decirle «sí».
Los límites de WIP tienen poco que ver con la configuración de Jira. Lo que cuenta es si el equipo y sus stakeholders tienen la disciplina de terminar antes de empezar.
9. Cómo introducir límites de WIP sin que el equipo se rebele
Las matemáticas son una cosa. Convencer al sistema de adoptarlas es otra. Son muchísimos los equipos que han leído sobre límites de WIP, han intentado implantarlos y han abandonado el intento sin hacer ruido. Diría que la mayoría.
Así es como suele fallar. Alguien, normalmente el engineering manager o un ingeniero senior que ha leído el libro de Kanban, anuncia: «a partir del lunes, el límite de WIP es de 5 por desarrollador, sin excepciones». Dos semanas después ha desaparecido. Los motivos de su muerte son previsibles:
- Los desarrolladores ven a compañeros bloqueados en revisión o en QA, se niegan a «quedarse de brazos cruzados» mientras haya trabajo en el backlog y, sin decir nada, empiezan tickets nuevos de todas formas
- Un stakeholder necesita algo urgente, el engineering manager recibe presión desde arriba y el límite se suspende «solo por esta vez»
- La dirección pasa por la zona de ingeniería, ve a gente que no está tecleando a la vista y pregunta por qué el equipo no está aprovechado al máximo
El error es introducir los límites de WIP como una regla, cuando lo que hace falta es un cambio de foco. A casi nadie, ni a los desarrolladores ni a la dirección, la regla en sí le resulta intuitiva. Visto desde fuera, decirle a un desarrollador que no tome trabajo nuevo parece irracional. Va contra la mentalidad de la escasez, en una cultura que premia empezar cosas.
Por eso rara vez empiezo por el límite en sí. Empiezo por desplazar el foco del equipo de empezar trabajo a terminarlo. El límite se interioriza después del cambio de foco, y nunca antes.
La secuencia que uso, más o menos:
- Haz explícito el objetivo. El objetivo es terminar el trabajo que ya se ha empezado; empezar más no suma nada. Repítelo con regularidad. Escríbelo donde todos lo vean. Lo que haga falta para que el mensaje cale.
- Explica por qué. Enséñale al equipo la ley de Little. Enséñale el diagnóstico de contar tareas por estado. Argumenta con las matemáticas del sistema en lugar de con la autoridad. La gente sigue mucho mejor las prácticas que entiende que las reglas que no entiende.
- Muestra ejemplos reales. Cita casos en los que introducir límites de WIP cambió el sistema de forma visible: tus propios equipos anteriores, artículos como este, historias de otros. Reconocer el patrón consigue casi todo lo que las exhortaciones no logran.
- Vuelve a centrar el foco, a menudo. Cada vez que alguien esté a punto de tomar una tarea nueva, pregúntale: «¿qué puedes hacer ahora mismo para que el trabajo que ya está en marcha llegue al final?». Ayudar a desbloquear a un compañero. Hacer una revisión. Responder una pregunta de QA. Resolver en pareja un conflicto de merge que lleva tiempo abierto. El instinto del equipo es tomar trabajo nuevo; la disciplina consiste en redirigir ese instinto.
Hay una historia, de un comentario en uno de mis propios artículos, que lo resume bien. Un equipo fijó un WIP = 5. Al principio los stakeholders lo vieron como un fracaso: demasiado pocas cosas visiblemente en marcha a la vez. En un trimestre había mejorado la velocidad de entrega, había mejorado la calidad, había mejorado la colaboración, había mejorado la previsibilidad. La visión de los stakeholders dio la vuelta. Dejaron de preguntar «¿por qué hay tan pocas cosas activas?» y empezaron a preguntar «¿por qué no usamos límites de WIP en otras partes de la empresa?».
La mayor resistencia suele venir de la capa de gestión que confunde utilización con productividad. Si todo el equipo está «ocupado al 100 %», la dirección se siente tranquila; si alguien está visiblemente entre dos tickets, saltan las alarmas. La verdad, incómoda, es que un equipo que funciona al 100 % de utilización casi siempre entrega menos que uno que funciona al 80 %. El margen libre en el sistema es lo que permite que el trabajo fluya.
Los límites de WIP no tienen por qué seguir el Kanban al pie de la letra. No hace falta imprimir números en el tablero. Basta con que el equipo y sus stakeholders acuerden, en la práctica: terminamos antes de empezar.
10. La visión completa del sistema: velocidad, valor y sostenibilidad de la entrega
La velocidad por sí sola no da la imagen completa. Cualquier marco de métricas de ingeniería que solo optimice la velocidad acabará rompiendo algo más importante.
El modelo de diagnóstico completo tiene tres dimensiones:
Velocidad del sistema: lo rápido que lanzamos los cambios.
- T2M (Time to Market): el tiempo total de la idea a producción
- Throughput: tareas terminadas por periodo
- Lead Time, Cycle Time, WIP: la descomposición que ya hemos recorrido
Valor del producto: si lo que lanzamos es útil de verdad.
- Calidad: bugs abiertos, tasa de regresiones, tasa de incidencias
- NPS / satisfacción del cliente: si el usuario siente que el producto mejora
Sostenibilidad del equipo: si el equipo puede seguir funcionando así.
- eNPS (Employee NPS): si el equipo recomendaría trabajar aquí
- Señales de burnout, tasa de rotación, carga de guardias
Las tres importan, y a la vez, porque dos cualesquiera se pueden maquillar temporalmente a costa de la tercera. Puedes lanzar más rápido saltándote QA y quemando al equipo: la velocidad sube, y el valor y la sostenibilidad se hunden. Puedes pulir la calidad hasta la perfección y no lanzar nada: el valor por función sube, pero el equipo y la empresa se estancan. Puedes tener al equipo contento y sin hacer nada: la sostenibilidad es excelente y la velocidad es cero.
Un proceso de entrega que funciona mantiene las tres dimensiones en tensión. Es lo bastante rápido para que el negocio pueda competir, lo bastante valioso para que los clientes se queden y lo bastante sostenible para que el equipo siga aquí el año que viene. Cuando los fundadores me preguntan cómo es «lo bueno», esta es la respuesta: tres números que se mueven más o menos a la par, en lugar de uno solo.
El eNPS en particular se pasa por alto porque parece más blando que el resto. En realidad es el sistema de alerta temprana de todo lo demás. Un equipo cuyo eNPS baja empezará a perder a sus seniors en tres a seis meses. Los sustituirán juniors que necesitan tiempo para arrancar. El WIP subirá, el conocimiento se diluirá, la calidad bajará, los bugs se multiplicarán. La métrica que viste moverse primero era la que ignoraste.
Casi todas se pueden calcular con Jira y una encuesta de clima de RR. HH. Ninguna exige una herramienta especial. Lo que exigen es la voluntad de mirar el sistema con honestidad, en sus tres dimensiones a la vez.
Cuando las métricas se convierten en una herramienta de diagnóstico
Las métricas no son nuevas. Las ideas tampoco: la teoría de restricciones (años ochenta), el Sistema de Producción de Toyota (años cincuenta), el método Kanban para software (David Anderson, años dos mil) y la ley de Little (1961) describen aspectos distintos del mismo problema de fondo: el trabajo se mueve a través de sistemas, y los sistemas se ralentizan cuando el flujo se rompe. Lo nuevo es si tu equipo las usa como informe o como diagnóstico. Un informe te dice que algo está roto. Un diagnóstico te dice dónde.
Cuando la entrega es lenta, la tentación es reaccionar al informe: contratar ingenieros, añadir procesos, instalar una herramienta nueva. La reacción parece movimiento. Normalmente se queda en eso. El progreso empieza cuando las métricas se vuelven lo bastante concretas para señalar la restricción real.
Si tienes delante un tablero con 60–80 tareas activas y un equipo de seis personas, cuenta las tareas por estado. Mide el Lead Time y el Cycle Time. Mira la relación entre el WIP y el throughput. Las matemáticas del sistema harán la mayor parte del trabajo.
Preguntas frecuentes
¿Qué diferencia hay entre Lead Time y Cycle Time?
- Lead Time
- El tiempo total que una tarea pasa dentro del desarrollo, desde «lista para desarrollo» hasta «en producción». Incluye la espera.
- Cycle Time
- Solo la parte de trabajo activo, desde «alguien empieza de verdad a trabajar en ella» hasta «terminada». Excluye la espera.
La diferencia entre los dos es la profundidad de la cola.
¿Qué límite de WIP es razonable para un equipo de N personas?
Las recomendaciones del sector van de 1 a 3 tareas por desarrollador; los equipos de desarrollo de software suelen quedarse en la parte baja: 1–2 por desarrollador.
Equipo de 6 → unas 6–12 tareas activas en todo el sistema, no 80.
El número exacto importa menos que la disciplina de tener uno y hacerlo cumplir: la mayoría de los equipos encuentran su nivel empezando con un límite estricto y relajándolo si el trabajo se atasca una y otra vez por motivos ajenos al WIP.
¿En qué se diferencia esto de la capacidad del sprint en Scrum?
- Capacidad del sprint
- Cuánto trabajo se compromete a hacer el equipo en un periodo de dos semanas.
- Límite de WIP
- Cuánto trabajo hay en marcha en un momento dado, sea cual sea el sprint.
Un equipo puede tener un compromiso de sprint sensato y aun así llevar más de 60 tareas en paralelo: la capacidad del sprint no dice nada sobre si el trabajo se termina o solo se empieza. Los límites de WIP son independientes de la planificación del sprint y suelen resolver problemas a los que la planificación del sprint por sí sola no llega.
¿Y si nuestro throughput es realmente demasiado bajo?
A veces el throughput sí es la restricción. Si el WIP ya está bajo control y el Lead Time sigue alto, puede que el equipo no tenga capacidad suficiente para la demanda.
Antes de contratar, comprueba tres cosas:
- ¿Las tareas son demasiado grandes?
- ¿La ejecución en sí es lenta?
- ¿El equipo dedica mucho tiempo a trabajo ajeno a la entrega? Soporte, incidencias, reuniones, carga operativa.
Si todo eso está en orden y el throughput sigue por debajo de la demanda, contratar puede ser la decisión correcta. Los límites de WIP no sustituyen a la contratación: ayudan a distinguir un problema de capacidad de un problema de flujo.