Метрики разработки
Где ломается разработка и как найти узкое место
Когда команда медленно выпускает продукт, кажется, что люди мало успевают. Чаще работа просто застревает по дороге. И первое, что обычно делают в ответ, замедляет систему ещё сильнее.
За эти годы я много раз видел одну и ту же картину. В команде шесть человек, на доске 60–80 активных задач. Релизы растянулись сначала с дней до недель, потом до «займёмся в следующем месяце». И вывод вполне разумный: нужно больше рук. Только узкое место обычно сидит глубже.
Диагностика разбирает путь одной задачи от идеи до пользователя по шагам, пока не найдётся этап, на котором система перестаёт работать. Когда этап найден, решение обычно очевидно, и чаще всего для него никого не нужно нанимать. Статья идёт в том же порядке, что и реальный проект: симптомы → разложение → поиск узкого места → выбор рычага.
1. Симптомы медленной разработки и неверный первый рефлекс
Первый разговор почти всегда начинается одинаково. T2M измеряется месяцами. Пропускная способность близка к нулю. Багов на доске больше, чем открытых задач. NPS, внутренний или внешний, где-то между плохим и очень плохим.
Инженеры работают, руководитель разработки старается, продакт-менеджер разгребает бэклог. И всё равно первый рефлекс каждый раз один: «нам нужно больше инженеров». Рефлекс неверный.
Объясню почему. Когда программа сломалась, никто не чинит её, добавляя в репозиторий разработчиков. Открывают отладчик и смотрят: в каком она состоянии, где застревает, что делает и чем это отличается от ожидаемого. С системой разработки так же. Метрики выше говорят, что результат плохой, но не говорят, где система ломается. Если расширять команду вслепую, система становится сложнее: задачи чаще передают из рук в руки, незавершённой работы больше, очереди длиннее. И почти всегда всё идёт медленнее.
Поэтому прежде чем говорить о найме, разберите процесс на части и найдите, где он начинает проседать. С этого момента метрики перестают быть табелем успеваемости и становятся инструментом диагностики.
2. Разложите T2M: Discovery и Lead Time — это разные проблемы
Любая задача начинается с сырой идеи: запрос клиента, баг-репорт, гипотеза основателя, чьё-то замечание на встрече. Прежде чем команда за неё возьмётся, идею надо довести до ума: понять, что имеется в виду, набросать решение, решить, стоит ли за неё браться, собрать согласования. Этот этап проходит не каждая идея, и не всегда быстро.
Здесь многие команды теряют недели и не замечают этого. T2M (Time to Market) — всё время от идеи до продакшена. Первым делом его стоит разрезать по границе между Discovery и Delivery.
Discovery — всё, что происходит, пока задача не готова к тому, чтобы её взял разработчик: уточнение требований, дизайн, оценка объёма, согласование со стейкхолдерами, приоритизация. На выходе получается задача, которую можно начинать делать.
Delivery — всё, что после: от «готова к разработке» до «в продакшене». Большинство метрик разработки по умолчанию меряют именно эту часть. И только её команда контролирует напрямую.
Вторую половину я меряю метрикой Lead Time: это время, которое задача проводит в руках команды разработки. Получается:
T2M = Discovery + Lead Time (Delivery)
За одним плохим T2M прячутся два числа и две очень разные проблемы.
Если T2M высокий, а Lead Time низкий, узкое место стоит до разработки. Делать команда умеет, но работа застряла на анализе, ждёт ответа стейкхолдера или решения о приоритете, которое так и не приняли. Нанимать инженеров бесполезно: новые люди будут ждать вместе со старыми. Чинить нужно Discovery: кто решает, что задача готова, как часто и на каком основании.
Если высокий Lead Time, проблема внутри Delivery. Задачи застревают уже после того, как команда их взяла: в разработке, на ревью, в QA, на деплое. Нужно разобрать Lead Time и понять, куда именно уходит время.
У большинства команд, с которыми я работаю, проблемы есть с обеих сторон, но редко поровну. Разделив T2M и Lead Time, вы прежде всего поймёте, с какого разговора начинать. Про Discovery обычно говорят с основателем, продакт-менеджером и тем, кто отвечает за приоритеты. Про Delivery — с руководителем разработки и командой. Смешаете два разговора — почти наверняка будете чинить не то.
Внутри Lead Time задача «в работе» и задача, над которой работают, — разные вещи. Отсюда начинается самое интересное.
3. Lead Time = ожидание + Cycle Time
Большинство команд считают, что раз задача «готова к разработке», работа над ней началась. На деле её просто поставили на доску. Разработчик занят предыдущей. Кто-то в отпуске. Срочный баг лезет без очереди. Задача лежит. На доске она «в работе», а на деле ждёт.
Поэтому одного Lead Time мало. Нужно отделить время, когда над задачей работают, от времени, когда она лежит в очереди. Для этого я использую Cycle Time: время с момента, когда задачу всерьёз взяли в работу, до момента, когда она готова. Только сама работа, без ожидания.
Всё вместе:
Lead Time = ожидание + Cycle Time
Cycle Time = только работа
Отсюда ещё два вопроса для диагностики.
Если высокий Cycle Time, проблема в самой разработке. Задача медленно доходит до конца, даже когда над ней уже работают. Узкое место в исполнении: запутанный код, долгое ревью, нестабильные тесты, ручное тестирование по кругу, мучительные деплои. С этого и начинайте разбор вместе с командой.
Если Cycle Time низкий, а Lead Time высокий, с командой и с исполнением всё в порядке. Просто работы приходит больше, чем система успевает переварить. Задачи копятся в очереди и ждут, пока команда разделается с предыдущей порцией.
Второй случай застаёт основателей врасплох. Каждую задачу команда делает быстро, а доска всё равно стоит. Хочется надавить на людей, чтобы работали быстрее. А проблема в том, что работы приходит больше, чем команда может сделать. Выхода тут два: точечно добавить людей или ограничить, сколько работы команда берёт одновременно. К этому мы ещё вернёмся.
Шпаргалка для первого разговора с руководством:
| Что показывает метрика | Что это значит |
|---|---|
| Высокий Cycle Time | Проблема в исполнении. Разбирайтесь внутри разработки. |
| Высокий Lead Time, нормальный Cycle Time | Работы приходит больше, чем команда успевает сделать. |
| Низкий Cycle Time, низкий Lead Time, высокий T2M | Узкое место в Discovery. |
Всего три числа, и все вытаскиваются из Jira или Linear за полдня. Картина сразу получается подробнее, чем «надо нанимать».
4. Где застревает работа и почему время в статусах обманывает
Допустим, Cycle Time высокий. Дальше напрашивается заглянуть внутрь и замерить время в каждом статусе: в работе, на ревью, в QA, на деплое. Посчитать, куда уходят часы, найти самую медленную колонку и починить её.
Так делает большинство команд, и до какого-то предела это работает. Если задачи застревают на код-ревью, время в колонке даёт повод для предметного разговора: сколько ревью висит на каждом, какого размера пулл-реквесты, как быстро их смотрят. Так же с QA и с очередью на деплой. Данные настоящие, правки точечные.
Но тут есть ловушка, и её стоит описать точно.
Задачи часто откатываются назад: из QA в разработку, когда нашли баг; с ревью в работу, когда пришёл комментарий; с деплоя в разработку, когда что-то упало на стейджинге. Одна задача проходит один и тот же этап два, три, а то и пять раз. Начнёте мерить «среднее время в QA», и в этом среднем незаметно смешаются задачи на первом круге и задачи, которые вернулись в QA уже в третий раз.
Обычно тут команды начинают мерить ещё усерднее. Дашборды подробнее. Каждый переход на учёте. Метрики вроде «доля задач, не прошедших QA с первого раза» и «возвраты с ревью на задачу». Свои отчёты в Jira. Получается красивый инструмент, с которым непонятно что делать: данные усложнились быстрее, чем стала понятнее система.
Ошибка в уровне, на котором меряют систему. Ускорять каждую колонку по отдельности имеет смысл, если работа идёт по прямой. А система разработки больше похожа на реку с водоворотами, петлями и заводями, чем на конвейер.
Посмотрите, как работа движется через систему целиком. Сколько задач в ней одновременно? Сколько из них движется, а сколько лежит? С этими вопросами остальная диагностика становится намного проще.
5. Как найти узкое место, не измеряя время
Это самый недооценённый приём диагностики из тех, что я знаю.
Чтобы найти узкое место, не нужно измерять время в каждом статусе. Достаточно посчитать задачи в каждом статусе.
Эти числа вытаскиваются из Jira за пять минут. Обычно картина примерно такая:
Потом ищите перекосы.
Если у вас пять задач в разработке, три на ревью и двадцать пять в QA, секундомер не нужен, как и дашборд в Looker. Узкое место — QA. Задачи копятся там в очереди, даже если каждая по отдельности проходит быстро: работа приходит туда быстрее, чем уходит.
Один такой подсчёт скажет почти всё, что и время в статусах, примерно за процент усилий. Очередь — видимая часть проблемы с потоком: где она образуется, там система упёрлась в потолок своей мощности.
Меняется и сам разговор. Время в статусах вызывает спор, сколько дней в QA — это уже слишком долго. Подсчёт задач делает проблему очевидной: двадцать пять задач на двух тестировщиков — так устроена система, и призывом «тестировщикам надо работать быстрее» это не исправить.
Это самая дешёвая и быстрая проверка из всех, и большинство команд проскакивают её по пути к дашбордам, которыми потом никто не пользуется.
Но за ней встаёт вопрос поглубже. Почему в QA двадцать пять задач? Откуда они взялись? Почему команда берёт новую работу, когда в системе уже стоит стена незаконченных задач?
6. Скоростью управляет незавершённая работа (WIP)
Шесть инженеров. Восемьдесят задач в работе. Ничего не доходит до конца.
Я не преувеличиваю: видел ровно такую картину несколько раз. Трое разработчиков, двое тестировщиков, техлид — и больше восьмидесяти активных задач на доске. На шестерых.
История всегда одна. Разработчик доделывает свою часть и отправляет задачу на ревью. Теперь она ждёт кого-то другого. Чтобы не сидеть без дела, он берёт из бэклога следующую. Та тоже встаёт: ждёт QA. Он берёт ещё одну. Доска заполняется задачами, которые формально «в работе», а на деле ждут кого-то где-то по какой-то причине.
Это и есть незавершённая работа (Work in Progress, WIP): сколько задач система держит одновременно.
Шесть человек физически не могут работать над восемьюдесятью задачами сразу. Большая часть просто лежит: ждёт ревью, застряла в QA, отложена, потому что стейкхолдер не ответил, или частично сделана и смержена, но не задеплоена. И каждая занимает место: в чьей-то голове, на доске, в списке того, о чём кому-то надо помнить.
Цена растёт:
- Пока задачи ждут, они становятся бизнесу не так нужны. Когда команда до них добирается, требования уже поменялись или срочность прошла.
- Копятся конфликты слияния. Ветка, которая три недели лежит, пока основная уходит вперёд, превращается в маленькую археологическую экспедицию.
- Переключение контекста обходится всё дороже. У каждого разработчика в голове три-четыре задачи «в работе», и ни одна толком не движется.
- Баги проскакивают легче: чем больше работы в процессе, тем меньше внимания каждой задаче, и качество падает.
Метрики это подтверждают. Где высокий WIP, там и высокий T2M (задачи дольше выходят), и низкая пропускная способность (за неделю закрывается меньше задач), и больше багов (меньше внимания на задачу), и ниже NPS — и у клиентов, и у команды.
Вот что управляет системой: сколько работы команда пытается держать в процессе одновременно. Скорость людей и опыт инженеров тут вторичны.
7. Закон Литтла: Lead Time = WIP / Throughput
Если кажется, что все предыдущие разделы приходят к одному и тому же выводу, вам не кажется. Этому есть причина.
Исследование операций разобралось с этим десятки лет назад. Как объём работы в системе связан с тем, сколько эта работа длится, описывает закон Литтла:
Lead Time = WIP / Throughput
На языке разработки:
- WIP — сколько задач находится в системе одновременно
- Throughput — сколько задач команда заканчивает за период
- Lead Time — сколько в среднем задача живёт в системе
Формула почти до неприличия простая, а вывод из неё жёсткий.
Если пропускная способность не меняется, а WIP растёт, Lead Time растёт линейно. Возьмём команду, которая закрывает десять задач в неделю.
10 задач в системе → средний Lead Time ≈ 1 неделя
30 задач → ≈ 3 недели
80 задач → ≈ 8 недель
Во всех трёх случаях команда работает с одной скоростью. Инженеры не стали медленнее, задачи не стали сложнее. Изменилось только число задач, которые система держит одновременно. А средний Lead Time вырос в 8 раз.
Поэтому команда, которая работает усерднее, не обязательно выпускает быстрее. Усилиями можно поднять пропускную способность на 10–20%. Дисциплиной можно снизить WIP на 50% и больше. По математике второй рычаг сильнее.
И поэтому же «нам нужно больше инженеров» так часто делает только хуже. Новые инженеры приносят с собой новую незавершённую работу. WIP растёт быстрее пропускной способности, и Lead Time сначала ухудшается и лишь потом улучшается. Из-за онбординга это почти неизбежно: новичкам нужно шесть-восемь недель, чтобы стать заметно полезными, а у команды тем временем растёт WIP (менторство, передача контекста, ревью их пулл-реквестов).
Если запомнить одну формулу, то эту: Lead Time = WIP / Throughput.
Эта математика стоит почти за каждым разговором «мы слишком медленно работаем», который у меня был.
8. WIP-лимиты: рычаг, который вылечит большинство медленных команд
Раз скоростью системы управляет WIP, а пропускную способность быстро не поменяешь, рычаг очевиден: ограничить WIP.
У большинства команд проблема с продуктивностью растёт из проблемы с WIP. Почините WIP, и почти все остальные симптомы ослабнут разом: долгий Lead Time, частые баги, непредсказуемые сроки, постоянное переключение контекста.
WIP-лимит означает: в системе одновременно не больше N задач. Если WIP на пределе, новую работу не начинают, пока не закончат что-то из текущей. Точка.
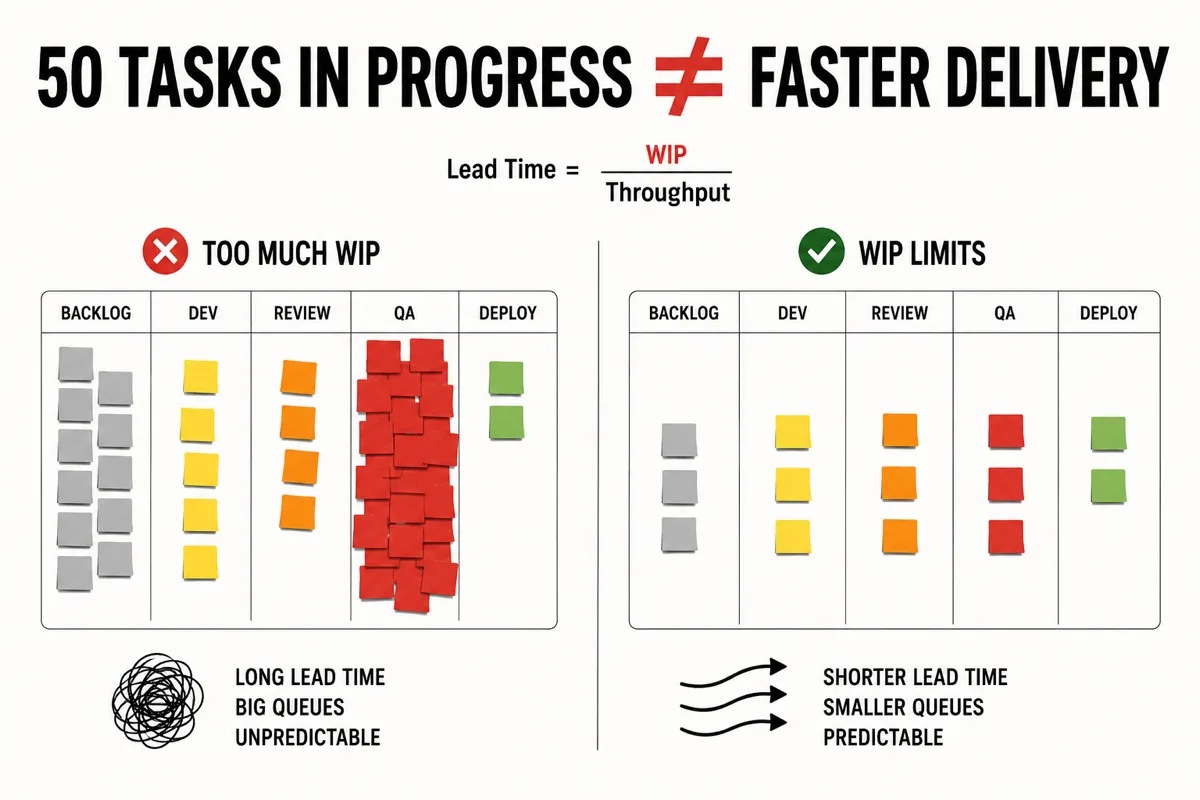
Что дают WIP-лимиты:
- Меньше переключений контекста: у каждого меньше задач в процессе
- Короче очереди на каждом этапе: в системе в целом меньше работы
- Короче Lead Time — механически, по закону Литтла
- Меньше багов: внимание уходит на то, чтобы закончить задачу
- Предсказуемее сроки: система перестаёт метаться между простоем и заторами
Руководство здесь обычно сбивает с толку одно: каждый разработчик работает в прежнем темпе, а система целиком ускоряется. Кода на человека в час пишется столько же. Зато недоделанных кусков параллельно висит меньше, и большая часть сделанного доходит до релиза.
К тому же это один из немногих рычагов, которые улучшают разработку без найма, новых инструментов и перестройки процессов. Он ничего не стоит, и его можно включить на этой неделе. Почти никто этого не делает: придётся говорить «нет» новой работе, а отказать стейкхолдеру, который просит взять ещё одну задачу, труднее, чем согласиться.
Всё упирается в дисциплину: готовы ли команда и стейкхолдеры сначала заканчивать, а потом начинать. Настройки Jira тут дело десятое.
9. Как ввести WIP-лимиты без бунта в команде
Понять математику — одно, а заставить систему по ней жить — другое. Очень много команд прочитали про WIP-лимиты, попробовали их ввести и тихо бросили. Подозреваю, что большинство.
Проваливается это обычно так. Кто-то, чаще всего руководитель разработки или сеньор после книги про канбан, объявляет: «С понедельника WIP-лимит — 5 задач на разработчика, без исключений». Через две недели от лимита ничего не остаётся. Причины предсказуемы:
- Разработчики видят, что коллеги ждут ревью или QA, не хотят «сидеть без дела», пока в бэклоге есть работа, и потихоньку всё равно берут новые задачи
- Стейкхолдеру срочно что-то нужно, на руководителя разработки давят сверху, и лимит отменяют «только в этот раз»
- Руководство проходит мимо разработчиков, видит, что люди не стучат по клавиатуре, и спрашивает, почему команда загружена не полностью
WIP-лимит, объявленный правилом, обычно умирает. Приживается он, когда его вводят как смену фокуса. Само правило интуитивно непонятно почти никому, ни разработчикам, ни руководству. Запрет брать новую работу со стороны выглядит нелепо: он идёт против культуры, где поощряют начинать новое.
Поэтому я редко начинаю с самого лимита. Сначала я перевожу внимание команды с того, чтобы начинать работу, на то, чтобы её заканчивать. Лимит приживается уже потом.
Примерно так:
- Назовите цель вслух. Цель — доводить до конца уже начатое. Повторяйте это регулярно, напишите на стикере, делайте что угодно, лишь бы мысль закрепилась.
- Объясните почему. Покажите команде закон Литтла и подсчёт задач по статусам. Убеждайте математикой системы: ссылки на авторитет тут не сработают. Люди гораздо охотнее следуют практике, которую понимают, чем правилу, которого не понимают.
- Покажите реальные примеры. Приводите случаи, когда WIP-лимиты заметно изменили систему: из ваших прошлых команд, из статей вроде этой, из историй коллег. Когда человек узнаёт свою ситуацию, это убеждает лучше любых призывов.
- Почаще возвращайте фокус. Когда кто-то собирается взять новую задачу, спрашивайте: «Что ты можешь сделать прямо сейчас, чтобы довести до конца уже начатое?» Разблокировать коллегу. Провести ревью. Ответить на вопрос из QA. Вместе разобрать застарелый конфликт слияния. Команду тянет хвататься за новое, и дисциплина в том, чтобы раз за разом поворачивать её к уже начатому.
Под одним из моих постов в комментариях рассказали историю. Команда ввела WIP = 5. Стейкхолдеры сначала решили, что это провал: заметного происходило слишком мало. За квартал выросли скорость, качество, взаимодействие в команде и предсказуемость. Стейкхолдеры поменяли мнение. Вместо «почему в работе так мало задач» они начали спрашивать «почему у нас нет WIP-лимитов в остальной компании».
Труднее всего обычно с руководством, для которого загрузка и продуктивность — одно и то же. Если все в команде «загружены на 100%», начальству спокойно. Если кто-то заметно сидит между задачами, начинается тревога. А команда с загрузкой 100% почти всегда выпускает меньше, чем команда с загрузкой 80%. Работа проходит через систему как раз благодаря запасу.
WIP-лимиты не обязательно вводить по канбану, с цифрами над колонками доски. Достаточно, чтобы команда и стейкхолдеры договорились и держались этого: сначала заканчиваем, потом начинаем.
10. Система целиком: скорость, ценность и устойчивость
Одна скорость полной картины не даёт. Если оптимизировать метрики разработки только под скорость, рано или поздно сломается что-то важнее.
Полная модель диагностики смотрит на систему с трёх сторон:
Скорость системы — как быстро мы выпускаем изменения.
- T2M (Time to Market) — всё время от идеи до продакшена
- Throughput — сколько задач закончено за период
- Lead Time, Cycle Time, WIP — разложение, которое мы уже разобрали
Ценность продукта — приносит ли пользу то, что мы выпускаем.
- Качество — открытые баги, доля регрессий, частота инцидентов
- NPS и удовлетворённость клиентов — чувствует ли пользователь, что продукт становится лучше
Устойчивость команды — сможет ли команда и дальше так работать.
- eNPS (NPS сотрудников) — посоветовали бы люди из команды знакомым работать здесь
- Признаки выгорания, текучесть, нагрузка от дежурств
Смотреть нужно на все три сразу, потому что любые два можно на время накрутить за счёт третьего. Можно выпускать быстрее, пропуская QA и выжигая команду: скорость растёт, ценность и устойчивость рушатся. Можно довести качество до совершенства и ничего не выпускать: ценность каждой функции растёт, а команда и компания стоят на месте. Можно держать команду довольной и ничем не загружать: устойчивость отличная, скорость нулевая.
Здоровая система разработки держит все три в равновесии. Она достаточно быстрая, чтобы бизнес выдерживал конкуренцию, приносит достаточно пользы, чтобы клиенты не уходили, и достаточно устойчива, чтобы через год команда была на месте. Когда основатели спрашивают меня, что такое «хорошо», я отвечаю: три числа, которые движутся примерно вместе. Одного числа мало.
Чаще всего упускают eNPS: эта метрика кажется мягче остальных. Зря, она первой предупреждает о проблемах во всём остальном. Команда, у которой падает eNPS, через три-шесть месяцев начнёт терять сеньоров. На их место придут джуны, которым нужно время, чтобы войти в курс дела. WIP вырастет, знания размажутся, качество упадёт, багов станет больше. И первой сдвинется как раз та метрика, на которую вы не смотрели.
Почти всё это считается по Jira и пульс-опросу от HR. Специальный инструмент не нужен ни для одной метрики. Нужна только готовность честно посмотреть на систему сразу с трёх сторон.
Когда метрики становятся инструментом диагностики
Ни метрики, ни идеи за ними не новые: теория ограничений (1980-е), производственная система Toyota (1950-е), метод канбан для разработки ПО (Дэвид Андерсон, 2000-е) и закон Литтла (1961) описывают одну проблему с разных сторон: работа идёт через систему, и когда поток ломается, система замедляется. Новым может быть только одно: как ваша команда ими пользуется, для отчёта или для диагностики. Отчёт говорит, что что-то сломано. Диагностика говорит, где.
Когда разработка буксует, хочется реагировать на отчёт: нанять инженеров, добавить процессов, купить новый инструмент. Это похоже на движение, но обычно ничего не меняет. Дело сдвигается, когда метрики становятся настолько конкретными, что показывают на настоящее ограничение.
Если перед вами доска с 60–80 активными задачами и команда из шести человек, посчитайте задачи по статусам. Измерьте Lead Time и Cycle Time. Сравните WIP с пропускной способностью. Большую часть работы за вас сделает математика.
Частые вопросы
Чем Lead Time отличается от Cycle Time?
- Lead Time
- Всё время, которое задача проводит в разработке, от «готова к разработке» до «в продакшене», вместе с ожиданием.
- Cycle Time
- Только активная работа, от момента, когда задачу взяли в работу, до «готово». Без ожидания.
Разница между ними показывает глубину очереди.
Какой WIP-лимит разумен для команды из N человек?
Обычно советуют от 1 до 3 задач на разработчика. Команды разработки, как правило, держатся ближе к нижней границе: 1–2 задачи на разработчика.
Команда из 6 человек → ~6–12 активных задач на всю систему вместо 80.
Точное число менее важно, чем дисциплина: лимит должен быть, и его надо соблюдать. Свой уровень большинство команд находят так: начинают с жёсткого лимита и ослабляют его, если работа регулярно встаёт по причинам, не связанным с WIP.
Чем это отличается от ёмкости спринта в Scrum?
- Ёмкость спринта
- Сколько работы команда берёт на двухнедельный спринт.
- WIP-лимит
- Сколько работы в процессе в каждый момент, независимо от спринта.
У команды может быть разумный план на спринт и при этом 60+ задач в работе одновременно: по ёмкости спринта не видно, заканчивается работа или только начинается. WIP-лимиты работают отдельно от планирования спринта и обычно решают проблемы, до которых одним планированием не дотянуться.
Что делать, если пропускной способности и правда не хватает?
Бывает, что команда и правда упирается в пропускную способность. Если WIP уже под контролем, а Lead Time остаётся высоким, возможно, команда просто не тянет такой объём работы.
Прежде чем нанимать, проверьте три вещи:
- Не слишком ли крупные задачи?
- Не медленно ли идёт сама работа?
- Не уходит ли много времени на дела помимо разработки? Поддержка, инциденты, встречи, операционная нагрузка.
Если с этим всё в порядке, а пропускной способности всё равно не хватает, нанимать, возможно, уже пора. WIP-лимиты помогают отличить нехватку людей от проблемы с потоком; решение о найме принимается отдельно.