Software-Delivery
So finden Sie heraus, wo Ihre Software-Delivery wirklich hakt
Die meisten langsamen Entwicklungsteams leiden an einem Flussproblem, auch wenn alle produktiv arbeiten. Und fast jede erste Reaktion darauf macht das System noch langsamer.
Ein Muster, das ich über die Jahre oft gesehen habe: ein Team aus sechs Leuten mit 60–80 aktiven Aufgaben auf dem Board, Releases, die sich von Tagen auf Wochen und dann auf „machen wir nächsten Monat“ gedehnt haben, und der sehr naheliegende Schluss, dass mehr Leute das Problem lösen. Meist liegt der eigentliche Engpass woanders.
Die Diagnose zerlegt den Weg einer einzelnen Aufgabe von der Idee bis zum Nutzer, bis Sie auf die konkrete Stelle zeigen können, an der das System versagt. Sobald diese Stelle sichtbar ist, liegt die Lösung meist auf der Hand, und in den meisten Fällen braucht sie keine einzige Neueinstellung. Die Reihenfolge unten folgt einem echten Projekt: Symptome → Zerlegung → Engpass finden → über den Hebel sprechen.
1. Symptome langsamer Delivery und der falsche erste Reflex
Das erste Gespräch beginnt fast immer gleich. T2M liegt bei Monaten. Der Durchsatz ist nahe null. Auf dem Board stehen mehr Bugs als offene Aufgaben. Der NPS des Teams, intern wie extern, bewegt sich irgendwo zwischen schlecht und schlechter.
Die Entwickler arbeiten, der Engineering Manager (EM) bemüht sich, der Product Manager (PM) kämpft sich durch das Backlog. Und trotzdem lautet der erste Reflex jedes Mal: „Wir brauchen mehr Entwickler.“ Genau dieser Reflex führt in die Irre.
Der Grund ist einfach. Wenn ein Programm nicht funktioniert, reparieren wir es nicht, indem wir mehr Entwickler auf den Quellcode ansetzen. Wir öffnen einen Debugger. Wir schauen, in welchem Zustand das Programm ist, wo es hängt und was es tatsächlich tut, verglichen mit dem, was wir erwartet haben. Für ein Entwicklungssystem gilt dasselbe. Die Kennzahlen oben zeigen, dass das Ergebnis schlecht ist. Wo das System versagt, zeigen sie nicht. Wer das Team ohne diese Information vergrößert, macht das System nur komplexer: mehr Übergaben, mehr angefangene Arbeit, längere Warteschlangen. Und fast immer wird es dadurch langsamer.
Bevor also über Einstellungen gesprochen wird, gilt es, den Prozess in seine Teile zu zerlegen und die Stelle zu finden, an der er nachlässt. In diesem Moment hören die Kennzahlen auf, ein Zeugnis zu sein, und werden zum Diagnosewerkzeug.
2. T2M zerlegen: Discovery und Lead Time sind zwei verschiedene Probleme
Wenn eine Aufgabe zum ersten Mal auftaucht, ist sie eigentlich noch keine Aufgabe. Sie ist eine rohe Idee: ein Kundenwunsch, ein Fehlerbericht, eine Hypothese des Gründers, etwas, das jemandem im Meeting aufgefallen ist. Bevor das Team sie umsetzen kann, muss jemand sie formen: klären, was sie bedeutet, eine Lösung skizzieren, entscheiden, ob sie sich lohnt, die nötigen Freigaben einholen. Nicht jede Idee übersteht diese Phase, und die, die es schaffen, schaffen es nicht immer schnell.
Diese Lücke ist wichtig, weil viele Teams genau hier Wochen verlieren, ohne es zu merken. T2M, Time to Market, ist die gesamte Zeit von der Idee bis zur Produktion. Der erste sinnvolle Schnitt verläuft an der Grenze zwischen Discovery und Delivery.
Discovery ist alles, was passiert, bevor ein Ticket wirklich bereit ist, von einem Entwickler übernommen zu werden: Anforderungen klären, Design, Umfang festlegen, Stakeholder abstimmen, priorisieren. Das Ergebnis ist ein Ticket, mit dessen Umsetzung jemand tatsächlich beginnen könnte.
Delivery ist alles danach, von „bereit für die Entwicklung“ bis „in Produktion“. Das messen die meisten Entwicklungsmetriken stillschweigend, und auf diesen Abschnitt hat das Team direkten Einfluss.
Für die zweite Hälfte nutze ich die Lead Time: die Zeit, die ein Ticket im Verantwortungsbereich des Entwicklungsteams verbringt. Also:
T2M = Discovery + Lead Time (Delivery)
Zwei Zahlen und zwei sehr unterschiedliche Probleme, die sich hinter einer schlechten T2M verstecken.
Ist T2M hoch, die Lead Time aber niedrig, liegt der Engpass vor der Entwicklung. Das Team kann liefern, aber die Arbeit hängt in der Analyse, wartet auf einen Stakeholder oder steht hinter einer Priorisierungsentscheidung, die niemand getroffen hat. Mehr Entwickler helfen hier nicht, sie säßen nur auf andere Weise untätig herum. Reparieren müssen Sie den Discovery-Prozess: wer entscheidet, was bereit ist, in welchem Rhythmus und auf welcher Grundlage.
Ist die Lead Time hoch, steckt das Problem in der Delivery selbst. Aufgaben bleiben hängen, nachdem das Team sie übernommen hat: beim Programmieren, im Review, in der QA, beim Deployment. Dann muss man in die Lead Time hineinschauen und herausfinden, wo genau die Zeit verloren geht.
In der Praxis haben die meisten Teams, mit denen ich arbeite, auf beiden Seiten Probleme, aber selten im gleichen Verhältnis. Der Schnitt zwischen T2M und Lead Time zeigt Ihnen als Erstes, welches Gespräch Sie zuerst führen sollten. Über Discovery sprechen Sie meist mit dem Gründer, dem PM und demjenigen, der die Priorisierung verantwortet. Über Delivery sprechen Sie mit dem EM und dem Team. Wer beides vermischt, landet ziemlich zuverlässig bei der falschen Lösung.
Innerhalb der Lead Time zeigt sich dann, dass „an einer Aufgabe arbeiten“ und „die Aufgabe wird bearbeitet“ zwei verschiedene Dinge sind. Hier wird es interessant.
3. Lead Time = Wartezeit + Cycle Time
Die meisten Teams glauben, dass die eigentliche Arbeit beginnt, sobald eine Aufgabe „bereit für die Entwicklung“ ist. Das stimmt nicht. Die Aufgabe landet auf dem Board. Ein Entwickler steckt noch in der vorherigen. Jemand ist im Urlaub. Ein dringenderer Bug drängelt sich vor. Das Ticket liegt einfach da. Für das Board ist die Aufgabe „in Bearbeitung“. Für das System wartet sie nur.
Deshalb ist die Lead Time allein nicht scharf genug. Wir müssen die Zeit, in der an einer Aufgabe tatsächlich gearbeitet wird, von der Zeit trennen, in der sie nur in der Warteschlange liegt. Dafür nutze ich die Cycle Time: die Zeit von dem Moment, in dem eine Aufgabe wirklich übernommen wird, bis zu dem, in dem sie fertig ist. Nur echte Arbeit.
Zusammengesetzt:
Lead Time = Wartezeit + Cycle Time
Cycle Time = nur Arbeit
Daraus ergeben sich zwei weitere Diagnosefragen.
Ist die Cycle Time hoch, liegt das Problem in der Entwicklung selbst. Sobald jemand an einer Aufgabe arbeitet, dauert es lange, bis sie fertig ist. Der Engpass steckt in der Umsetzung: komplexer Code, langsame Reviews, instabile Tests, manuelle QA-Runden, mühsame Deployments. Dort fangen Sie gemeinsam mit dem Team an zu suchen.
Ist die Cycle Time niedrig, die Lead Time aber hoch, ist mit dem Team alles in Ordnung. Auch die Umsetzung stimmt. Im System kommt mehr Arbeit an, als es bewältigen kann. Aufgaben stauen sich in der Warteschlange und warten darauf, dass das Team den vorherigen Schwung abschließt, bevor sie überhaupt beginnen können.
Dieser zweite Fall erwischt Gründer oft kalt. Das Team ist bei jeder einzelnen Aufgabe schnell. Trotzdem wirkt das Board wie eingefroren. Der Instinkt ist, beim Einzelnen mehr Tempo einzufordern, obwohl das eigentliche Problem darin liegt, dass die Nachfrage die Kapazität des Teams übersteigt. Das richtige Gespräch dreht sich hier darum, gezielt Kapazität aufzubauen oder zu begrenzen, wie viel Arbeit das Team gleichzeitig annimmt. Dazu kommen wir noch.
Eine kurze Diagnosetabelle für das erste Gespräch mit der Geschäftsführung:
| Was die Kennzahl zeigt | Was das bedeutet |
|---|---|
| Hohe Cycle Time | Problem in der Umsetzung: in die Entwicklung hineinschauen. |
| Hohe Lead Time, normale Cycle Time | Die Nachfrage übersteigt die Kapazität. |
| Niedrige Cycle Time, niedrige Lead Time, hohe T2M | Der Engpass liegt in der Discovery. |
Das sind drei Zahlen. Sie bekommen alle an einem Nachmittag aus Jira oder Linear, und schon sie erzählen eine andere Geschichte als „wir müssen einstellen“.
4. Wo Arbeit wirklich hängen bleibt und warum die Zeit pro Status täuschen kann
Die Cycle Time ist also hoch. Der naheliegende nächste Schritt ist, in sie hineinzuschauen und die Zeit pro Status zu messen: In Progress, Code Review, QA, Deploy. Zusammenrechnen, wo die Stunden hingehen. Die langsamste Spalte finden. Sie reparieren.
So gehen die meisten Teams vor, und bis zu einem gewissen Punkt funktioniert es. Wenn Ihre Aufgaben im Code Review hängen bleiben, können Sie die Zeit in der Spalte ablesen und ein echtes Gespräch über die Last der Reviewer, die Größe der Pull Requests und die Fristen für Reviews beginnen. Dasselbe gilt für Engpässe in der QA und Warteschlangen beim Deployment. Die Daten sind echt, und der Eingriff ist gezielt.
Allerdings gibt es eine Falle, und die möchte ich genau beschreiben.
Aufgaben laufen nicht linear durch die Phasen. Sie springen zurück: aus der QA in die Entwicklung, wenn ein Bug gefunden wird, aus dem Review zurück in die Arbeit, wenn ein Kommentar kommt, aus dem Deployment zurück in die Entwicklung, wenn auf Staging etwas schiefgeht. Dieselbe Aufgabe durchläuft dieselbe Phase zwei-, drei-, manchmal fünfmal. Sobald Sie die „durchschnittliche Zeit in der QA“ messen, mischt dieser Durchschnitt stillschweigend Tickets im ersten Durchlauf mit solchen, die schon zum dritten Mal in der QA landen.
An diesem Punkt messen die meisten Teams noch mehr. Feinere Dashboards. Jeden Übergang erfassen. Kennzahlen für „Fehlerquote in der QA beim ersten Durchlauf“ und „Review-Rückläufer pro Ticket“ einführen. Eigene Jira-Berichte bauen. Am Ende steht ein schönes Instrument, aus dem niemand etwas ableiten kann, weil die Daten schneller kompliziert geworden sind, als das System darunter klarer wurde.
Der Fehler: Sie messen das System auf der falschen Ebene. Lokale Optimierung, also jede Spalte schneller zu machen, setzt voraus, dass Arbeit linear fließt. Tatsächlich gleicht das System einem Fluss mit Strudeln, Schleifen und Staus.
Was wirklich hilft: aufhören, jede Phase noch genauer zu messen, und stattdessen fragen, wie Arbeit durch das System als Ganzes fließt. Die Frage lautet dann: „Wie viele Tickets sind gleichzeitig im System, und welcher Anteil davon kommt tatsächlich voran, statt nur dort zu liegen?“ Sobald Sie so fragen, wird der Rest der Diagnose deutlich einfacher.
5. Engpässe finden, ohne Zeit zu messen
Das ist der am meisten unterschätzte Diagnoseschritt, den ich kenne.
Um den Engpass zu finden, müssen Sie die Zeit pro Status gar nicht messen. Es reicht, die Aufgaben in jedem Status zu zählen.
Die Zahlen holen Sie in fünf Minuten aus Jira. Das Bild sieht fast immer ungefähr so aus:
Dann suchen Sie nach Ungleichgewichten.
Wenn fünf Aufgaben in der Entwicklung sind, drei im Review und fünfundzwanzig in der QA, brauchen Sie keine Stoppuhr. Sie brauchen kein Looker-Dashboard. Der Engpass ist die QA, denn dort stauen sich die Aufgaben. Das System hat eine Stelle, an der sich Arbeit schneller ansammelt, als sie abfließt.
Diese eine Zählung verrät Ihnen fast alles, was die Zeit pro Status verraten würde, bei etwa einem Prozent des Aufwands. Sie funktioniert, weil Warteschlangen die sichtbare Seite eines Flussproblems sind: Wo sich eine Schlange bildet, stößt das System an die Grenze seiner Kapazität.
Außerdem verändert sie das Gespräch. Die Zeit pro Status lädt zu einer Debatte darüber ein, „wie lange in der QA zu lange ist“. Die Zählung macht das Problem offensichtlich: Fünfundzwanzig Aufgaben, die auf zwei QA-Ingenieure warten, sind ein Problem des Systems, und schnellere QA-Arbeit löst es nicht.
Das ist die günstigste und schnellste Diagnose im ganzen Leitfaden, und die meisten Teams überspringen sie auf dem Weg zu Dashboards, die sie nie benutzen werden.
Sie wirft aber eine tiefere Frage auf. Warum liegen fünfundzwanzig Aufgaben in der QA? Woher kommen sie? Warum nimmt das Team immer neue Arbeit an, obwohl schon eine Wand aus unfertigen Tickets im System steht?
6. Work in Progress (WIP): die Größe, die das Liefertempo bestimmt
Sechs Entwickler. Achtzig Aufgaben in Bearbeitung. Nichts wird fertig.
Das ist nicht übertrieben. Genau dieses Bild habe ich mehrfach gesehen. Ein Team aus drei Entwicklern, zwei QA-Ingenieuren und einem Tech Lead, und auf dem Board über achtzig aktive Tickets. Bei sechs Leuten.
Die Geschichte dahinter ist immer dieselbe. Ein Entwickler erledigt den aktiven Teil einer Aufgabe und schickt sie ins Review. Sein aktuelles Ticket wartet jetzt auf jemand anderen. Statt zu warten, holt er sich ein neues aus dem Backlog. Auch das bleibt hängen, diesmal in der QA. Er holt sich das nächste. Das Board füllt sich mit Aufgaben, die formal „in Bearbeitung“ sind, in Wahrheit aber auf jemand anderen warten, an anderer Stelle, aus anderem Grund.
Das ist Work in Progress (WIP): die Zahl der Aufgaben, die das System zu einem Zeitpunkt gleichzeitig hält.
Das Team kann physisch nicht an achtzig Dingen gleichzeitig arbeiten. Sechs Leute, achtzig Aufgaben. Der Großteil der Arbeit liegt einfach herum. Er wartet auf ein Review, hängt in der QA, ist geparkt, weil ein Stakeholder nicht antwortet, oder ist halb fertig und gemergt, aber noch nicht ausgerollt. Jedes dieser Tickets belegt einen Platz im System: einen Platz im Kopf von jemandem, einen Platz auf dem Board, einen Zustand, den jemand im Blick behalten muss.
Die Kosten summieren sich:
- Aufgaben verlieren während des Wartens an geschäftlicher Bedeutung. Bis das Team zu ihnen zurückkommt, haben sich die Anforderungen verschoben oder die Dringlichkeit ist verflogen.
- Merge-Konflikte häufen sich. Ein Feature-Branch, der drei Wochen liegt, während der Hauptzweig weiterläuft, wird zu einem kleinen archäologischen Projekt, sobald er integriert werden soll.
- Kontextwechsel werden teuer. Jeder Entwickler hält im Kopf drei oder vier Aufgaben „in Bearbeitung“. Keine davon kommt wirklich voran.
- Bugs rutschen leichter durch. Je mehr Arbeit gleichzeitig läuft, desto weniger Augen schauen auf jedes einzelne Stück. Die Qualität sinkt.
Die Kennzahlen bestätigen das. Hoher WIP geht einher mit hoher T2M (Aufgaben brauchen länger bis zur Auslieferung), niedrigem Durchsatz (pro Woche wird weniger fertig), mehr Bugs (weniger Aufmerksamkeit pro Aufgabe) und niedrigerem NPS, bei Kunden wie im Team.
Diese Größe steuert das System: wie viel das Team gleichzeitig in der Luft halten will. Sie wiegt schwerer als das Tempo des Teams und die Seniorität der Entwickler.
7. Little's Law: Lead Time = WIP / Durchsatz
Wenn Sie den Eindruck haben, dass die bisherigen Abschnitte immer wieder beim selben Schluss landen, täuschen Sie sich nicht. Das hat einen Grund.
Die Warteschlangentheorie hat das schon vor Jahrzehnten herausgefunden. Den Zusammenhang zwischen der Menge an Arbeit in einem System und der Zeit, die diese Arbeit braucht, beschreibt Little's Law:
Lead Time = WIP / Durchsatz
In der Sprache der Softwareentwicklung:
- WIP: wie viele Aufgaben gleichzeitig im System sind
- Durchsatz (Throughput): wie viele Aufgaben das Team pro Zeitraum abschließt
- Lead Time: wie lange eine Aufgabe im Schnitt im System bleibt
Die Formel ist fast schon peinlich einfach, und die Folgerung daraus ist brutal.
Bleibt der Durchsatz gleich und steigt der WIP, wächst die Lead Time linear mit. Ein Beispiel: ein Team, das zehn Aufgaben pro Woche abschließt.
10 Aufgaben im System → Lead Time im Schnitt ≈ 1 Woche
30 Aufgaben → ≈ 3 Wochen
80 Aufgaben → ≈ 8 Wochen
In allen drei Fällen arbeitet das Team gleich schnell. Die Entwickler sind nicht langsamer geworden. Die Tickets sind nicht komplexer. Geändert hat sich nur, wie viele Aufgaben das System gleichzeitig halten will. Und die durchschnittliche Lead Time hat sich verachtfacht.
Deshalb liefern Teams, die härter arbeiten, nicht unbedingt schneller. Mit Anstrengung holen Sie beim Durchsatz vielleicht 10–20 Prozent heraus. Mit Disziplin senken Sie den WIP um die Hälfte oder mehr. Die Rechnung zeigt: Der zweite Hebel bewegt mehr.
Und deshalb macht „wir brauchen mehr Entwickler“ die Lage so oft schlimmer. Neue Entwickler bringen ihre eigene angefangene Arbeit mit. Der WIP steigt schneller als der Durchsatz, und die Lead Time wird erst einmal schlechter, bevor sie besser wird. Das Onboarding macht das fast unvermeidlich: Neue Leute brauchen sechs bis acht Wochen, bis sie spürbar beitragen, und in dieser Zeit steigt der WIP des bestehenden Teams (Einarbeitung, Wissensübergabe, Reviews der Pull Requests der Neuen).
Wenn Sie sich nur eine Formel merken, dann diese: Lead Time = WIP / Durchsatz.
Das ist die Systemmathematik hinter fast jedem Gespräch über „wir sind zu langsam“, das ich je in der Entwicklung geführt habe.
8. WIP-Limits: der Hebel, der die meisten langsamen Teams wieder schnell macht
Wenn also der WIP die Größe ist, die das Tempo des Systems bestimmt, und sich der Durchsatz kurzfristig meist nicht drastisch ändern lässt, liegt der Hebel auf der Hand: den WIP begrenzen.
Die meisten Entwicklungsteams haben ein Produktivitätsproblem, weil sie ein WIP-Problem haben. Bringen Sie den WIP in Ordnung, und die meisten anderen Symptome verbessern sich gleichzeitig: lange Lead Times, häufige Bugs, geringe Planbarkeit, ständige Kontextwechsel.
WIP-Limits sind die Disziplin zu sagen: Dieses System hält höchstens N Aufgaben gleichzeitig. Ist das Limit erreicht, beginnt keine neue Arbeit, bis eine bestehende fertig ist. Punkt.
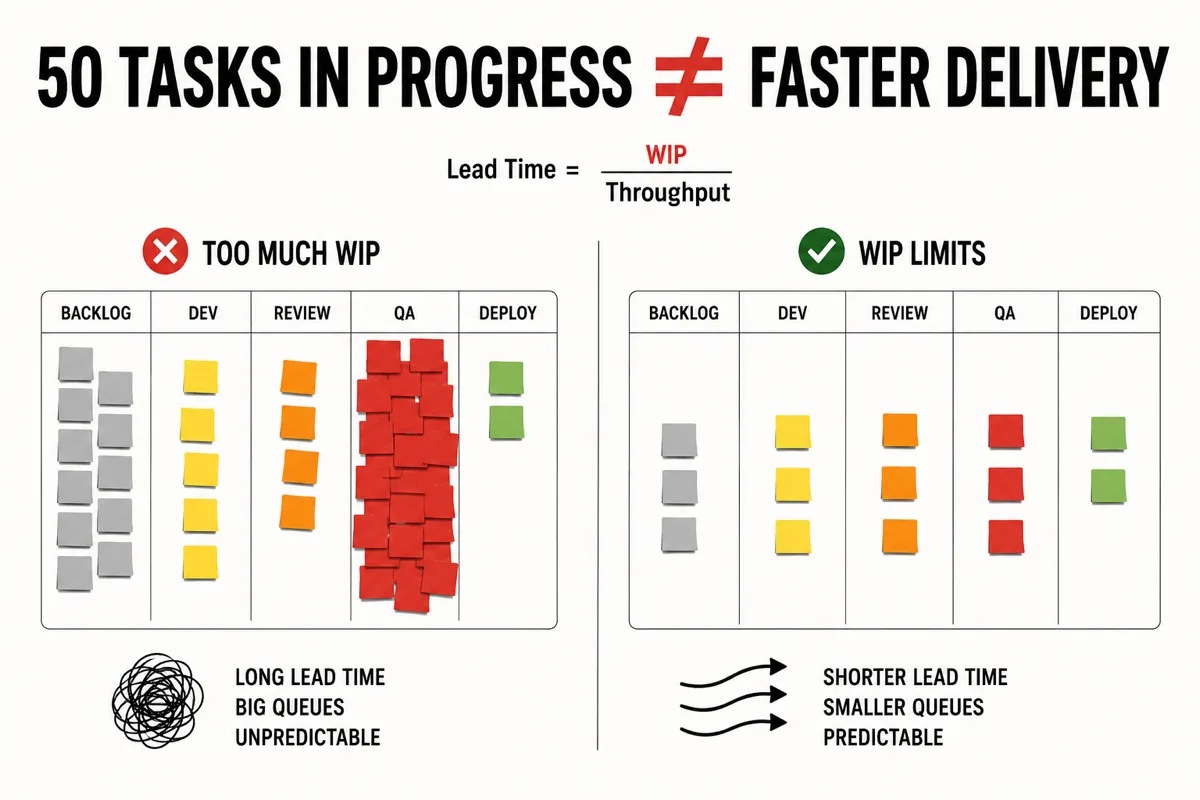
Was WIP-Limits tatsächlich verbessern:
- Weniger Kontextwechsel, weil jeder weniger gleichzeitig offene Dinge im Kopf hat
- Kürzere Warteschlangen in jeder Phase, weil insgesamt weniger im System ist
- Kürzere Lead Time, nach Little's Law ganz mechanisch
- Weniger Bugs, weil sich die Aufmerksamkeit aufs Abschließen richtet statt aufs Anfangen
- Mehr Planbarkeit, weil das System nicht mehr zwischen Leerlauf und Stillstand pendelt
Was die Geschäftsführung dabei oft verwirrt: WIP-Limits beschleunigen das System als Ganzes, während jeder Einzelne im gewohnten Tempo arbeitet. Pro Arbeitsstunde entsteht gleich viel Code, aber weniger halbfertige Teile parallel, und dadurch geht mehr von dem, was das Team produziert, tatsächlich live.
Es ist außerdem einer der ganz wenigen Hebel, der die Delivery ohne Neueinstellungen, ohne neue Tools und ohne Umbau der Prozesse verbessert. Er kostet nichts. Er lässt sich diese Woche einsetzen. Und fast niemand nutzt ihn, weil er verlangt, zu neuer Arbeit „Nein“ zu sagen. Einem Stakeholder, der noch eine Sache gleichzeitig angestoßen haben will, „Nein“ zu sagen, ist schwerer als „Ja“.
Bei WIP-Limits geht es letztlich um Disziplin: ob das Team und seine Stakeholder erst fertig machen und dann anfangen. Die Einstellungen in Jira sind Nebensache.
9. WIP-Limits einführen, ohne dass das Team rebelliert
Die Mathematik ist das eine. Das System dazu zu bringen, sie anzunehmen, etwas ganz anderes. Viele Teams haben über WIP-Limits gelesen, versucht, sie einzuführen, und den Versuch still wieder aufgegeben. Ich vermute, die meisten.
So läuft das Scheitern ab. Jemand, meist der EM oder ein Senior-Entwickler, der das Kanban-Buch gelesen hat, verkündet: „Ab Montag gilt ein WIP-Limit von 5 pro Entwickler, ohne Ausnahmen.“ Zwei Wochen später ist es verschwunden. Die Gründe sind vorhersehbar:
- Entwickler sehen Kollegen, die auf Review oder QA warten, wollen nicht „untätig herumsitzen“, solange im Backlog noch Arbeit liegt, und fangen still und leise doch neue Tickets an
- Ein Stakeholder braucht dringend etwas, der EM bekommt Druck von oben, und das Limit wird „nur dieses eine Mal“ ausgesetzt
- Die Geschäftsführung geht durch die Entwicklungsabteilung, sieht Leute, die gerade nicht sichtbar tippen, und fragt, warum das Team nicht voll ausgelastet ist
Der Fehler liegt darin, WIP-Limits als Regel einzuführen. Gebraucht wird eine Verschiebung des Fokus. Fast niemand, weder Entwickler noch Geschäftsführung, findet die Regel an sich einleuchtend. Von außen wirkt es irrational, einem Entwickler zu sagen, er solle keine neue Arbeit aufnehmen. Es widerspricht dem Instinkt, knappe Kapazität voll auszunutzen, und das in einer Kultur, die das Anfangen belohnt.
Deshalb beginne ich selten mit dem Limit selbst. Ich beginne damit, den Fokus des Teams vom Anfangen aufs Abschließen zu lenken. Das Limit wird erst verinnerlicht, wenn sich der Fokus verschoben hat.
Meine Reihenfolge sieht ungefähr so aus:
- Das Ziel ausdrücklich machen. Das Ziel ist, bereits begonnene Arbeit abzuschließen. Neue anzufangen ist zweitrangig. Wiederholen Sie das regelmäßig. Drucken Sie es auf einen Aufkleber. Was immer nötig ist, damit diese Sichtweise ankommt.
- Erklären, warum. Zeigen Sie dem Team Little's Law. Zeigen Sie die Diagnose mit den Aufgaben pro Status. Argumentieren Sie mit der Mathematik des Systems statt mit Ihrer Autorität. Menschen folgen Praktiken, die sie verstehen, viel bereitwilliger als Regeln, die sie nicht verstehen.
- Echte Beispiele zeigen. Verweisen Sie auf Fälle, in denen WIP-Limits das System sichtbar verändert haben: Ihre eigenen früheren Teams, Beiträge wie diesen, Erfahrungen anderer. Ein Muster, das Menschen wiedererkennen, bewirkt mehr als jeder Appell.
- Den Fokus immer wieder zurückholen. Wann immer jemand eine neue Aufgabe ziehen will, fragen Sie: „Was können Sie jetzt tun, um bestehende Arbeit zum Abschluss zu bringen?“ Einem Kollegen helfen, der feststeckt. Ein Review machen. Eine Frage aus der QA beantworten. Zu zweit einen lange offenen Merge-Konflikt lösen. Der Instinkt des Teams ist, sich frische Arbeit zu holen. Die Disziplin besteht darin, diesen Instinkt umzulenken.
In den Kommentaren zu einem meiner Beiträge stand eine Geschichte, die das gut zeigt. Ein Team setzte WIP = 5. Die Stakeholder hielten das zunächst für einen Fehlschlag: zu wenig sichtbar gleichzeitig in Arbeit. Innerhalb eines Quartals hatten sich Liefertempo, Qualität, Zusammenarbeit und Planbarkeit verbessert. Die Sicht der Stakeholder drehte sich. Bald fragten sie: „Warum nutzen wir WIP-Limits nicht auch in anderen Teilen des Unternehmens?“
Am schwierigsten ist meist die Managementebene, die Auslastung mit Produktivität gleichsetzt. Das Entwicklungsteam selbst ist selten das Problem. Wenn alle im Team „zu 100 Prozent ausgelastet“ sind, fühlt sich das Management wohl; sobald jemand sichtbar zwischen zwei Tickets steht, schrillen die Alarmglocken. Die unbequeme Wahrheit: Ein Team mit 100 Prozent Auslastung liefert fast immer weniger aus als ein Team mit 80 Prozent. Erst der Spielraum im System lässt die Arbeit hindurchfließen.
WIP-Limits müssen nicht nach Kanban-Lehrbuch aussehen. Sie müssen keine Zahlen aufs Board drucken. Es reicht, wenn sich das Team und seine Stakeholder in der Praxis einig sind: Wir machen fertig, bevor wir anfangen.
10. Das ganze System im Blick: Tempo, Wert und Nachhaltigkeit
Tempo allein ergibt kein vollständiges Bild. Jedes Metrik-Framework für die Entwicklung, das nur auf Tempo optimiert, macht früher oder später etwas Wichtigeres kaputt.
Das vollständige Diagnosemodell hat drei Dimensionen:
Tempo des Systems: wie schnell wir Änderungen ausliefern.
- T2M (Time to Market): die gesamte Zeit von der Idee bis zur Produktion
- Durchsatz: abgeschlossene Aufgaben pro Zeitraum
- Lead Time, Cycle Time, WIP: die Zerlegung, die wir schon durchgegangen sind
Wert für das Produkt: ob das, was wir ausliefern, wirklich nützt.
- Qualität: offene Bugs, Regressionsrate, Häufigkeit von Incidents
- NPS / Kundenzufriedenheit: ob die Nutzer spüren, dass das Produkt besser wird
Nachhaltigkeit im Team: ob das Team auf diese Weise weiterarbeiten kann.
- eNPS (Employee NPS): ob das Team die Arbeit hier weiterempfehlen würde
- Anzeichen von Burnout, Fluktuation, Last durch Bereitschaftsdienste
Alle drei zählen gemeinsam, weil sich zwei davon jederzeit vorübergehend auf Kosten der dritten schönen lassen. Sie können schneller ausliefern, indem Sie die QA überspringen und das Team verheizen: Das Tempo steigt, Wert und Nachhaltigkeit brechen ein. Sie können die Qualität bis zur Perfektion polieren und nichts ausliefern: Der Wert pro Feature steigt, aber Team und Unternehmen stagnieren. Sie können das Team zufrieden und untätig halten: Die Nachhaltigkeit ist großartig, das Tempo liegt bei null.
Ein funktionierendes Liefersystem hält alle drei Dimensionen im Gleichgewicht. Es ist schnell genug, damit das Unternehmen im Wettbewerb besteht, wertvoll genug, damit die Kunden bleiben, und nachhaltig genug, damit das Team auch nächstes Jahr noch da ist. Wenn Gründer mich fragen, wie „gut“ aussieht, ist das meine Antwort: drei Zahlen, die sich ungefähr gemeinsam bewegen.
Gerade der eNPS wird oft übersehen, weil er weicher wirkt als die anderen. Dabei ist er das Frühwarnsystem für alles andere. Ein Team mit sinkendem eNPS verliert in drei bis sechs Monaten die ersten erfahrenen Leute. Nachrücken werden Juniors, die Einarbeitung brauchen. Der WIP steigt, das Wissen wird dünn, die Qualität sinkt, die Bugs vermehren sich. Die Kennzahl, die sich zuerst bewegt hat, war genau die, die Sie ignoriert haben.
Fast alle diese Kennzahlen lassen sich aus Jira und einer kurzen Mitarbeiterumfrage berechnen. Ein spezielles Tool braucht keine davon. Was sie brauchen, ist die Bereitschaft, ehrlich auf das System zu schauen, auf alle drei Dimensionen zugleich.
Wenn Metriken zum Diagnosewerkzeug werden
Die Kennzahlen sind nicht neu. Die Ideen auch nicht: die Engpasstheorie (Theory of Constraints) (1980er), das Toyota-Produktionssystem (1950er), die Kanban-Methode für Software (David Anderson, 2000er) und Little's Law (1961) beschreiben verschiedene Seiten desselben Grundproblems: Arbeit bewegt sich durch Systeme, und Systeme werden langsamer, wenn der Fluss reißt. Neu ist allein die Frage, ob Ihr Team sie als Bericht oder als Diagnose nutzt. Ein Bericht sagt Ihnen, dass etwas kaputt ist. Eine Diagnose sagt Ihnen, wo.
Wenn die Delivery langsam ist, liegt es nahe, auf den Bericht zu reagieren: Entwickler einstellen, Prozesse hinzufügen, ein neues Tool einführen. Das sieht nach Bewegung aus. Fortschritt ist es meistens nicht. Fortschritt beginnt, wenn die Kennzahlen konkret genug werden, um auf den tatsächlichen Engpass zu zeigen.
Wenn Sie auf ein Board mit 60–80 aktiven Aufgaben und einem Team aus sechs Leuten blicken, zählen Sie die Aufgaben pro Status. Messen Sie Lead Time und Cycle Time. Schauen Sie sich das Verhältnis von WIP und Durchsatz an. Den Großteil der Arbeit erledigt dann die Mathematik des Systems.
Häufige Fragen
Was ist der Unterschied zwischen Lead Time und Cycle Time?
- Lead Time
- Die gesamte Zeit, die eine Aufgabe in der Entwicklung verbringt, von „bereit für die Entwicklung“ bis „in Produktion“. Die Wartezeit zählt mit.
- Cycle Time
- Nur der Teil mit aktiver Arbeit, von „tatsächlich begonnen“ bis „fertig“. Die Wartezeit zählt nicht mit.
Die Differenz zwischen beiden ist die Länge der Warteschlange.
Welches WIP-Limit ist für ein Team mit N Personen sinnvoll?
Gängige Empfehlungen liegen bei 1–3 Aufgaben pro Entwickler; Softwareteams arbeiten meist am unteren Ende, mit 1–2 pro Entwickler.
Team aus 6 Personen → etwa 6–12 aktive Aufgaben im ganzen System statt 80.
Die genaue Zahl ist weniger wichtig als die Disziplin, überhaupt ein Limit zu haben und es durchzusetzen. Die meisten Teams finden ihr Maß, indem sie eng anfangen und lockern, wenn Arbeit dauerhaft aus Gründen stockt, die nichts mit WIP zu tun haben.
Worin unterscheidet sich das von der Sprint-Kapazität in Scrum?
- Sprint-Kapazität
- Wie viel Arbeit sich das Team für zwei Wochen vornimmt.
- WIP-Limit
- Wie viel Arbeit in einem beliebigen Moment gleichzeitig in Bearbeitung ist, unabhängig vom Sprint.
Ein Team kann eine vernünftige Sprint-Planung haben und trotzdem 60+ Aufgaben parallel offen halten. Die Sprint-Kapazität sagt nichts darüber, ob Arbeit abgeschlossen oder nur begonnen wird. WIP-Limits stehen quer zur Sprint-Planung und lösen oft Probleme, an die die Sprint-Planung allein nicht herankommt.
Was, wenn unser Durchsatz tatsächlich zu niedrig ist?
Manchmal ist der Durchsatz wirklich der Engpass. Wenn WIP bereits im Griff ist und die Lead Time trotzdem hoch bleibt, fehlt dem Team womöglich Kapazität für die Nachfrage.
Prüfen Sie vor einer Neueinstellung drei Dinge:
- Sind die Aufgaben zu groß geschnitten?
- Ist die Umsetzung selbst langsam?
- Verbringt das Team viel Zeit mit Arbeit außerhalb der Entwicklung? Support, Incidents, Meetings, Betriebsaufwand.
Wenn all das sauber ist und der Durchsatz trotzdem hinter der Nachfrage zurückbleibt, kann eine Neueinstellung richtig sein. WIP-Limits ergänzen Neueinstellungen: Sie helfen zu unterscheiden, ob Ihnen Kapazität fehlt oder der Fluss der Arbeit gestört ist.