Agentes de IA
Agentes de IA no código: a periferia para eles, o núcleo para as pessoas
Agentes de IA são brilhantes em parte do trabalho e perigosos em outra. Deixe a periferia com eles e o núcleo com as pessoas: veja onde eles merecem o lugar e onde ainda não.
Um agente de IA consegue achar a causa de um bug num código que ninguém mexe há um ano e, na mesma tarde, colocar no ar com toda a confiança um bug que derruba o checkout, se você o deixar chegar perto do núcleo. A distância entre esses dois momentos é a mesma em qualquer escala. Para um fundador sozinho, ela perdoa; dentro de uma empresa, ela decide o jogo.
Para um fundador, quase tudo isso já está resolvido. No último ano, vi pessoas sem formação séria em engenharia construírem e fazerem crescer produtos reais por conta própria: um CRM para uma escola presencial, uma ferramenta para analistas de negócio, automação de marketing para uso próprio. O custo de entrada para construir despencou; dá para montar a coleta de métricas do Jira e do GitLab numa noite.
As armadilhas continuam lá: agentes perdem o contexto, geram código estranho, e alguns projetos descambam para o caos. Isso tem solução, e é boa parte do que eu faço; escrevi sobre o caminho de resgate em outro texto. Essa é a versão do fundador. O problema mais difícil e menos mapeado está um nível acima, dentro de uma empresa, e é para lá que este texto vai.
Dentro de uma empresa, a barreira real é o acesso ao agente
Em escala corporativa, o agente é igualmente capaz; a parte difícil é obter permissão para usá-lo. Em startups, a IA já é ferramenta padrão; dentro de uma empresa, a adoção emperra por semanas em aprovações: revisões de segurança, quais dados podem chegar ao modelo, quem é dono da plataforma, como os agentes são governados.
O que destrava tudo: nada precisa sair de casa. Dá para rodar uma API compatível com a da OpenAI inteiramente dentro do seu perímetro: um modelo open source como o Qwen servido via LiteLLM e vLLM, acessível só pela VPN corporativa, com um agente como Opencode ou Hermes ligado à IDE e servidores MCP conectando-o ao Jira, ao GitLab, ao Confluence e ao resto das suas ferramentas internas. Ele roda com as credenciais do próprio desenvolvedor, só acessa o que esse desenvolvedor já acessa e registra cada ação para auditoria. A segurança deixa de ser o bloqueio. Montar a stack completa é assunto para outro texto, mas ela já deixou de ser a barreira que era há um ano.
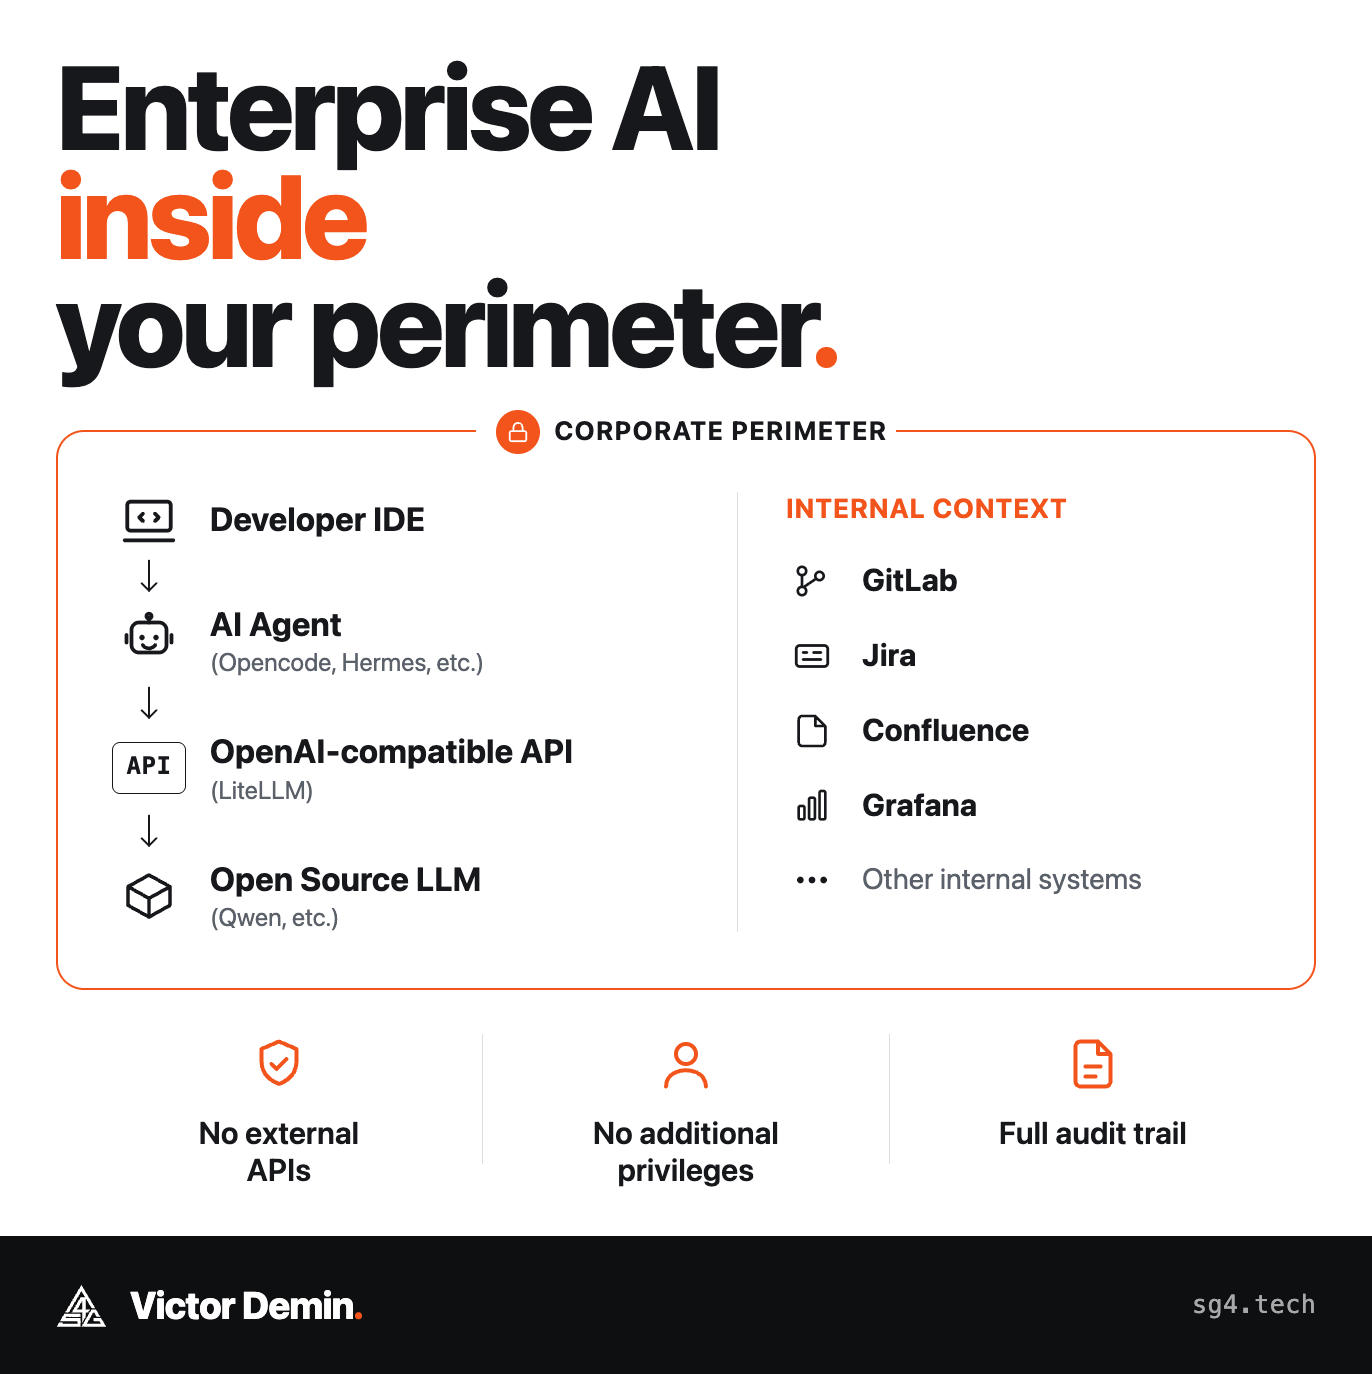
Uma vez instalado, seja no notebook do fundador ou na VPN corporativa, a pergunta é a mesma: o que exatamente você entrega a ele?
No que os agentes de IA são bons
Conectado ao seu código, à documentação, às tarefas, aos testes, aos logs e às métricas, seja o Cursor, o Claude Code ou um agente interno auto-hospedado, ele começa a entender o seu projeto. É aqui que ele merece o lugar.
- Entender rápido um código desconhecido: mergulhar num código em que você nunca mexeu, achar a causa de um bug numa funcionalidade de que você não sabe nada, responder à pergunta de um analista sobre uma funcionalidade de que você nunca tinha ouvido falar.
- Apoio ao desenvolvimento: as ferramentas e automações para as quais nunca sobrava tempo, como coleta de métricas, exportação de dados do Jira e do GitLab, skills de agente para trabalho repetitivo como integrações padrão. Fica de fora o produto principal, onde a qualidade do código é crítica.
- Artefatos em volta do código: documentação, diagramas UML, testes automatizados, casos no TestRail, apresentações.
- Revisões de código, de requisitos e de especificações. Por enquanto, meio a meio: às vezes é puro ruído, às vezes pega algo realmente útil.
O que não deve ficar nas mãos dos agentes de IA
O desenvolvimento de ponta a ponta de qualquer coisa que importe. Dinheiro, blockchains, sistemas de alta carga, a arquitetura central: qualquer lugar onde um erro é fácil de cometer e caro de desfazer. Numa startup, entregar uma funcionalidade inteira ao agente já funciona em parte; em produção, com tráfego real e dinheiro real em jogo, ainda é má ideia. Acelera o trabalho? Sim. Substitui um desenvolvedor sênior? Não.
A regra da periferia e do núcleo
O padrão é simples. O agente cobre a periferia do desenvolvimento: rotina, tarefas de apoio, navegação em código desconhecido, artefatos. Tudo o que tem muito volume e um custo de erro relativamente baixo. O núcleo, onde o custo de erro se mede em dinheiro e em usuários, fica com as pessoas.
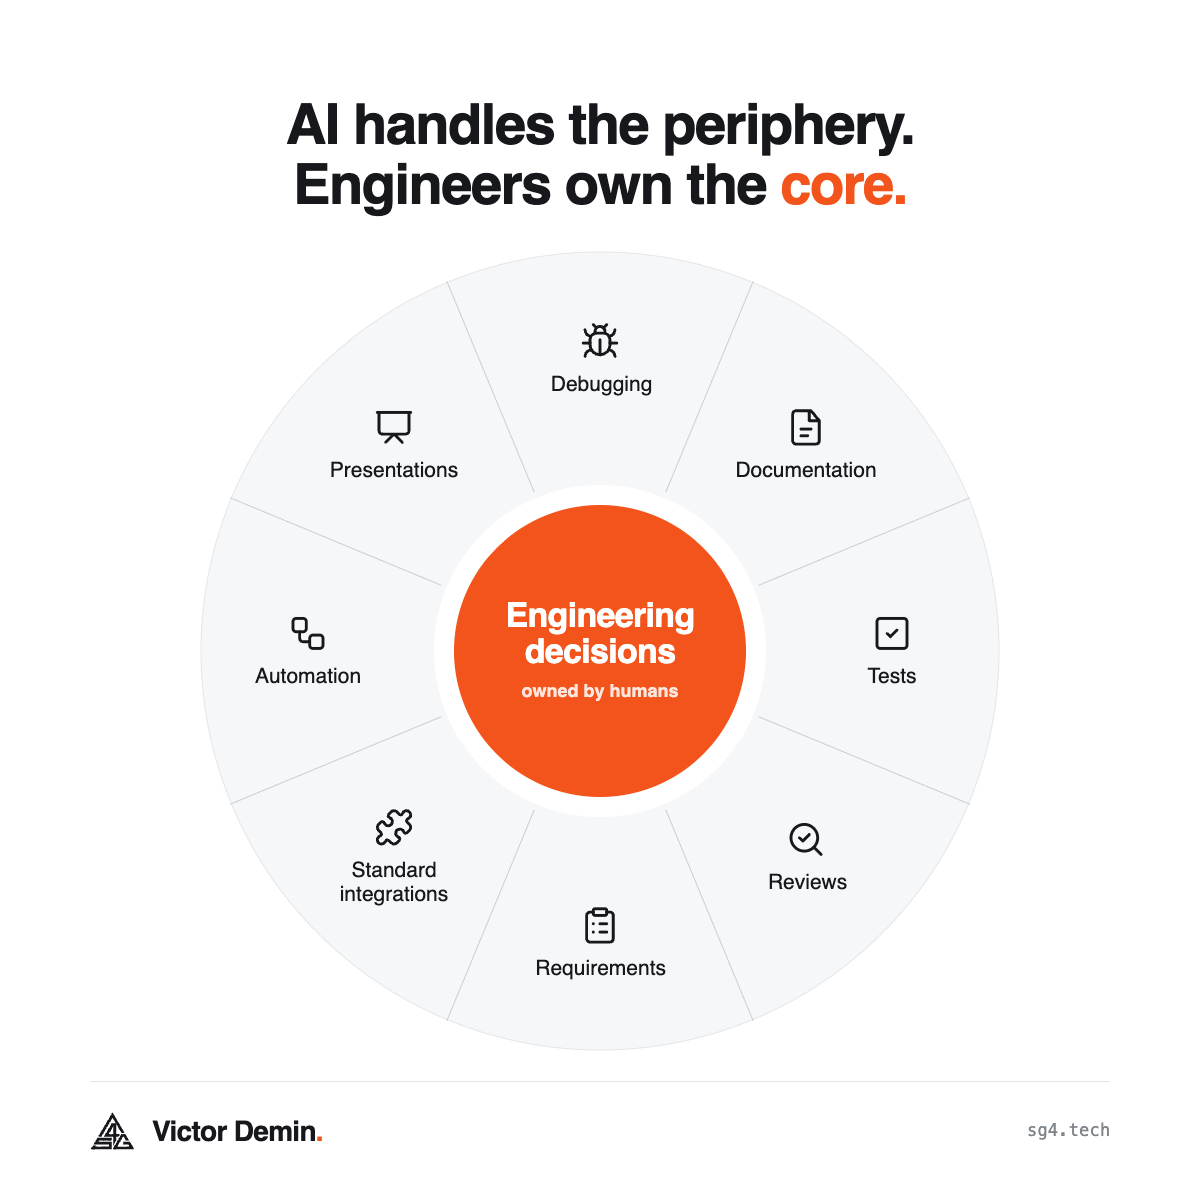
Engenheiros passavam horas procurando informação e dando conta da rotina. Agora o trabalho principal é tomar a decisão de engenharia certa.
Perguntas frequentes
Os agentes de IA precisam ser treinados ou ajustados com o nosso código?
Não. Eles trabalham lendo o código, a documentação, as tarefas e os logs que você já tem, na hora da execução, sem nenhum retreinamento. Por isso, configurar o acesso importa muito mais do que qualquer ajuste do modelo.
É melhor usar um serviço de IA na nuvem ou um modelo auto-hospedado?
Startups costumam começar com um serviço na nuvem; empresas reguladas ou sensíveis à segurança cada vez mais hospedam um modelo open source por conta própria, para que os dados nunca saiam do perímetro. A troca é entre controle e privacidade, de um lado, e o esforço de manter a stack você mesmo, do outro.
O que diferencia um agente de IA de um chatbot?
O acesso. Um chatbot responde com conhecimento geral; um agente conectado ao seu código, à documentação, às tarefas e aos logs age dentro do seu projeto real. É exatamente por isso que a linha entre o que ele deve e o que não deve tocar importa.
Fundadores sem formação técnica conseguem mesmo lançar produtos com agentes de IA?
Sim. O limite agora está em saber o que construir e em manter o código sustentável conforme ele cresce. Fundadores lançam produtos reais assim com frequência; quando dá errado, o motivo costuma ser a estrutura abandonada.